Всем привет, меня зовут Максим, я работаю инженером по тестированию железа в Selectel Lab.
Ранее мы протестили железо (наши конфиги в Селектел) на производительность в разных БД, тестирование было первым и теперь мы пошли дальше, так скажем углубились в исследование производительности БД на разных аппаратных платформах а также доработали существующие тесты БД.
Как и раньше одна из ключевых целей данного исследования является предоставление полезных данных клиентам Селектел для выбора подходящей конфигурации использования под различные БД. Также использование результатов командами Селектел для улучшения внутренних процессов, например в облачных базах данных.
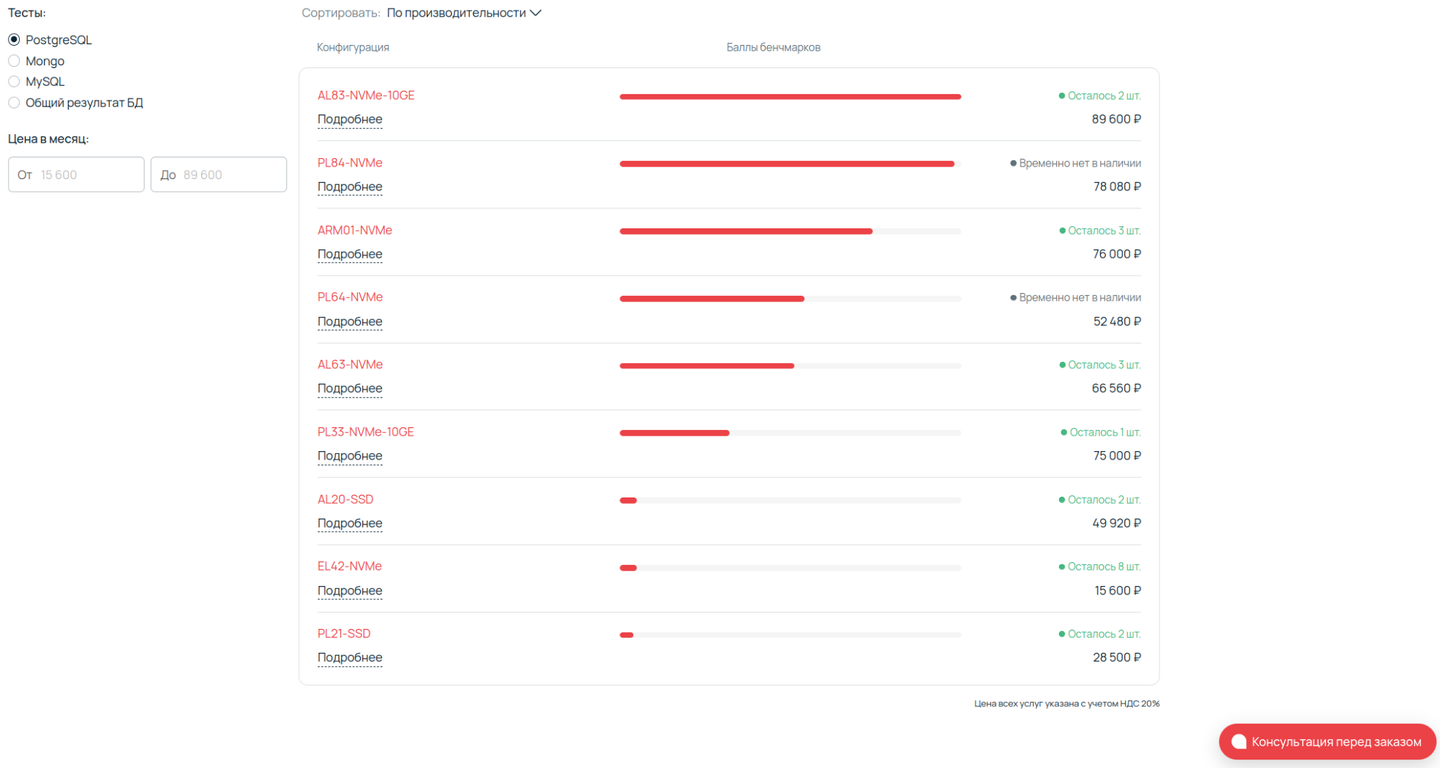
Как вы уже можете посмотреть эти данные уже работают и помогают нашим клиентам выбирать сервера по лучшей цене: https://selectel.ru/services/benchmarks/
Список выбранных конфигураций почти не отличается от прошлого тестирования (ссылка) в этот раз исключили кастом конфиг так как его не было в наличии, сервера выбраны по той же логике, из за АРМ платформы у которой наибольшее количество ядер и потоков, по этому выбраны платформы приближенные к этим показателям.
Все так же наш фаворит АРМ сервер с одним сокетом который по результатам прошлых тестов очень хорошо конкурирует с двухсокетными системами.
Можно увидеть в таблице RAM DDR4 одного вендора, такая же история с дисками все работают по протоколу NVMe по линиям PCIe gen 4.
ОС и виды тестов
Использовали Ubuntu 22.04 LTS.
Ранее я заметил и описал что: “выбор на 14 версию пал из за повышенной производительности, с дефолтными настройками постгреса в некоторых тестах в сравнении с 12 й версией производительность примерно возросла аж в 2 раза.” По этому в этот раз мы будем сравнивать свежие версии PSQL энтерпрайз и обычные версии 15-16.
Почему именно PSQL? — это одна из самых популярных БД среди наших пользователей.
Подготовка системы и БД
BIOS и ОС настроены в performance режиме:
BIOS:
Для анализа настроек BIOS для серверных платформ на базе процессоров Intel, AMD и Ampere рассмотрим ключевые настройки, которые могут влиять на максимальную производительность сервера. Здесь я указываю самые распространенные настройки.
Intel
Hyper-Threading(включен):
Описание: Технология Hyper-Threading позволяет каждому ядру процессора обрабатывать два потока выполнения одновременно, тем самым увеличивая количество одновременно обрабатываемых задач и улучшая эффективность использования ресурсов процессора.
Влияние на производительность: Включение Hyper-Threading может значительно улучшить производительность в многопоточных приложениях и средах, где одновременно выполняется множество задач, например, в серверах виртуализации.
Turbo Boost(включен):
Описание: Intel Turbo Boost Technology динамически увеличивает частоту работы ядер процессора выше их базовой тактовой частоты, если условия теплового пакета и энергопотребления позволяют.
Влияние на производительность: Это может значительно улучшить производительность для кратковременных высоконагруженных задач, обеспечивая при этом эффективное энергопотребление в периоды простоя.
VT-x/VT-d (Virtualization Technology)(включен):
Описание: VT-x улучшает поддержку виртуализации на уровне процессора, а VT-d добавляет поддержку аппаратной виртуализации ввода-вывода, что позволяет гостевым операционным системам более эффективно использовать аппаратные ресурсы.
Влияние на производительность: Эти технологии улучшают производительность и безопасность виртуализированных сред, снижая накладные расходы на эмуляцию аппаратного обеспечения и обеспечивая прямой доступ к устройствам.
Power Management (C-States, P-States)(включен P0):
Описание: C-States позволяют процессору переходить в состояния пониженного энергопотребления при простое, в то время как P-States регулируют производительность процессора, изменяя его частоту и напряжение в зависимости от текущей нагрузки.
Влияние на производительность: Правильная конфигурация этих состояний может помочь достичь оптимального баланса между производительностью и энергоэффективностью, особенно в средах с переменной нагрузкой.
Memory Configuration(включена максимальная частота и двухканальный режим):
Описание: Включает настройки, такие как выбор режима работы памяти (например, single, dual, quad channel) и ручная конфигурация времен задержек памяти.
Влияние на производительность: Оптимизация этих настроек может значительно улучшить пропускную способность и скорость доступа к памяти, что критически важно для производительности вычислительных систем.
AMD
SMT (Simultaneous Multithreading)(включен):
Описание и влияние: Аналогично Hyper-Threading у Intel, SMT увеличивает количество потоков, которые может обрабатывать каждое ядро, улучшая тем самым общую производительность системы в многопоточных приложениях.
Core Performance Boost(включен):
Описание: Технология, аналогичная Intel Turbo Boost, которая позволяет процессорам AMD повышать свою частоту выше базовой в зависимости от условий тепловыделения и энергопотребления.
Влияние на производительность: Это обеспечивает дополнительную производительность для задач, требующих высокой вычислительной мощности, при этом поддерживая энергоэффективность в менее интенсивных режимах.
AMD-V (Virtualization)(включен):
Описание и влияние: Улучшает производительность виртуализированных приложений за счет аппаратной поддержки виртуализации, аналогично технологиям VT-x/VT-d от Intel.
Power Management (Cool'n'Quiet, Global C-state Control)(отключен):
Описание: Эти настройки помогают управлять энергопотреблением процессора, регулируя его частоту и напряжение в зависимости от текущей нагрузки.
Влияние на производительность: Оптимизация этих настроек обеспечивает баланс между производительностью и энергоэффективностью, снижая энергопотребление в периоды низкой нагрузки без значительного влияния на производительность при высоких нагрузках.
Memory Interleaving(включен):
Описание: Настройка, позволяющая оптимизировать доступ к памяти, распределяя обращения к данным по различным каналам памяти.
Влияние на производительность: Это может значительно улучшить пропускную способность и время доступа к памяти, что особенно важно для приложений, интенсивно использующих память.
Ampere (ARM серверные процессоры)
Frequency Scaling(включен max_perfomance):
Описание: Настройка позволяет динамически изменять частоту процессора в зависимости от текущей рабочей нагрузки, оптимизируя тем самым энергопотребление и производительность.
Влияние на производительность: Это обеспечивает баланс между необходимой вычислительной мощностью и энергоэффективностью, адаптируясь к изменениям в рабочей нагрузке.
Memory Configuration(включена максимальная частота памяти):
Описание: Включает настройки таймингов памяти и конфигурации, направленные на оптимизацию скорости и пропускной способности памяти.
Влияние на производительность: Правильная настройка памяти критически важна для обеспечения высокой производительности системы, особенно в задачах с интенсивным использованием памяти.
Energy Efficiency Modes(отключен):
Описание: Настройки режимов энергоэффективности позволяют выбирать оптимальный баланс между производительностью и потреблением энергии.
Влияние на производительность: Возможность адаптации к различным рабочим условиям позволяет максимизировать производительность при минимальном энергопотреблении, что особенно важно для долгосрочной работы серверов.
Общие настройки для всех платформ
Memory Timing: Настройки таймингов памяти влияют на скорость обработки данных. Меньшие значения задержек (CAS Latency, tRCD, tRP, tRAS) могут улучшить производительность.
PCIe Settings: Конфигурация скорости и режима работы PCIe слотов может влиять на производительность подключенных устройств.
NUMA (Non-Uniform Memory Access) Configuration: Настройка оптимального использования памяти в системах с несколькими процессорами может существенно улучшить производительность приложений, чувствительных к задержкам доступа к памяти.
I/O Virtualization (SR-IOV, IOMMU): Настройки виртуализации ввода-вывода помогают улучшить производительность виртуализированных систем за счет более эффективной передачи данных между виртуальными машинами и физическими устройствами.
Специфические настройки для Intel
SpeedStep/EIST (Enhanced Intel SpeedStep Technology): Технология, позволяющая изменять частоту процессора в зависимости от нагрузки, для оптимизации потребления энергии и производительности.
Intel UPI Link Configuration: Настройка скорости и протоколов Intel Ultra Path Interconnect, соединяющего процессоры в многосокетных системах, может влиять на производительность памяти и общую производительность системы.
Intel VMD (Volume Management Device): Настройка, позволяющая управлять NVMe SSD дисками на уровне BIOS, может улучшить производительность и управляемость хранилища.
Специфические настройки для AMD
Precision Boost Overdrive (PBO): Функция, позволяющая превысить заводские ограничения процессора для достижения более высокой производительности при достаточном охлаждении.
Memory Access Mode: Настройка режима доступа к памяти (Distributed vs Local) для оптимизации производительности в зависимости от характера рабочей нагрузки.
Специфические настройки для Ampere
Core Frequency Scaling: Динамическая настройка частоты ядер в зависимости от нагрузки для баланса между производительностью и энергопотреблением.
Configurable TDP (Thermal Design Power): Настройка максимальной мощности, которую может потреблять процессор, позволяет управлять балансом между производительностью и тепловым режимом.
При настройке BIOS важно помнить о потенциальном влиянии изменений на стабильность и надежность системы. Рекомендуется провести тщательное тестирование после внесения изменений, чтобы убедиться, что система остается стабильной и надежной в рабочих условиях.
ОС:
При настройке ОС отключаем политики энергосбережения и включаем режим перфоманс (ubuntu 22.04)
echo performance | tee /sys/devices/system/cpu/cpu*/cpufreq/scaling_governor
В тестах используем максимальные рабочие частоты процессоров, максимальную частоту памяти, для двухсокетных систем, NUMA настроена на равномерное распределение памяти между CPU, охлаждение на максимум. В остальном сами настройки БД PSQL мы не трогаем за исключением количества подключений (MAX connection) и адреса где расположена БД (в данном случае локально, для прозрачности тестирования, исключения дополнительной точки отказа и сетевых задержек).
Дефолтные настройки PSQL мы используем по причине того что мы не знаем профиль нагрузки пользователя на систему и нам нужна точка отсчета производительности.
Выбор режима тестирования:
Используем уже известный нам бенчмарк pgbench который является дефолтным и встроенным в PostgreSQL.
Выбрали ключи(режимы) тестирования:
pgbench -T (смешаные запросы)
pgbench -S -T (SELECT ONLY)
pgbench -N -T (UPDATE)
Автоматизация теста pgbench
В ходе нескольких тестов стало понятно что вручную проводить данный тест довольно долго и тяжело, плюс при получении первых результатов поняли что есть погрешность в тестировании обусловленная работой железа, из за этого решили проводить тест три раза подряд и подсчетом средних значений по трем тестам для исключения этой погрешности.
Смысловая часть кода:
CORES=$((CPU_THREADS))
HOST="127.0.0.1"
TIME="600"
# Создаем базу данных генерим таблицы
pgbench —username=root -h "${HOST}" test -i -s 10000
# Считаем кол-во потоков и подключенных пользователей
THREADS=(1 2 $(echo "scale=0; $CORES * 20 / 100" | bc -l) \
$(echo "scale=0; $CORES * 40 / 100" | bc -l) \
$(echo "scale=0; $CORES * 60 / 100" | bc -l) \
$(echo "scale=0; $CORES * 80 / 100" | bc -l) \
$(echo "scale=0; $CORES * 99.9 / 100" | bc -l))
echo "pgbench —username=root -h ${HOST} test ${PARAM} -T ${TIME}" >> "${FILE}"
pgbench —username=root -h "${HOST}" test ${PARAM} -T "${TIME}" >> "${FILE}"
echo "pgbench —username=root -h ${HOST} test ${PARAM} -S -T ${TIME}" >> "${FILE}"
pgbench —username=root -h "${HOST}" test ${PARAM} -S -T "${TIME}" >> "${FILE}"
echo "pgbench —username=root -h ${HOST} test ${PARAM} -N -T ${TIME}" >> "${FILE}"
pgbench —username=root -h "${HOST}" test ${PARAM} -N -T "${TIME}" >> "${FILE}"
done
В данном коде получаем кол-во ядер и рассчитываем кол-во потоков в конкретной системе, далее указываем HOST что БД будет располагаться локально на машине, TIME — указываем время тестирования в секундах, после создаем БД “ test” и строки в данном тестировании создавался 1 миллиард строк что примерно 250GB по объему.
Как вы можете видеть в pgbench тесте используется 3 ключа для тестирования “-”, “-S ”, “-N”.
- — Смешанные SQL-запросы (Select, Update)
-S -T — упорядоченная последовательность SQL-запросов (Select only)
-N -T — режим простых SQL запросов запросы (Update only)
В конце тестирования получаем данные в виде текстового файла:
pgbench —username=admin -h 127.0.0.1 test -c 52 -j 26 -T 600
pgbench (14.6 (Ubuntu 14.6-0ubuntu0.22.04.1))
starting vacuum…end.
transaction type: <builtin: TPC-B (sort of)>
scaling factor: 10000
query mode: simple
number of clients: 52
number of threads: 26
duration: 600 s
number of transactions actually processed: 22881325
latency average = 1.363 ms
initial connection time = 235.470 ms
tps = 38150.347817 (without initial connection time)
Парсинг результатов в гугл таблицу.
После каждого теста у нас создавался.txt файл с большим количеством текста в котором зарыты нужные нам числа и результаты, вот пример скрипта которым я собирал данные и заносил в гугл таблицу:
#!/usr/bin/awk -f
BEGIN {
# Параметры таблицы, выравнивание
client_width = 10
thread_width = 12
tps_width = 20
trans_width = 20
latency_width = 20
init_conn_width = 25
# Вывод столбцов
printf "%-s%-s%-s%-s%-s%-s\n", "Num Clients", "Num Threads", "TPS", "Num Transactions", "Latency Average", "Initial Connection Time"
}
# Извлечение нужных значений из строки запуска pgbench
match($0, /-j\s+([0-9]+)/, arr) {
num_clients = arr[1]
}
match($0, /-c\s+([0-9]+)/, arr) {
num_threads = arr[1]
}
# Поиск по строкам нужных значений
/number of transactions actually processed:/ {
num_transactions = $NF
}
/latency average/ {
latency_average = $(NF-1) " " $NF
}
/initial connection time.*[0-9]+\.[0-9]+/ {
# Извлечение только числовых значений
for (i = 1; i <= NF; i++) {
if ($i ~ /^[0-9]+\.[0-9]+$/) {
init_conn_time = $i " " $(i+1)
break
}
}
}
/tps/ {
# Извлечение всех знаков (if present)
for (i = 1; i <= NF; i++) {
if ($i == "tps") {
tps = $(i+2)
gsub(/[()]/, "", tps) # Удаление TPS знач
break
}
}
# Вывод
printf "%-*s%-*s%-*s%-*s%-*s%-*s\n", client_width, num_clients, thread_width, num_threads, tps_width, tps, trans_width, num_transactions, latency_width, latency_average, init_conn_width, init_conn_time
}
в результате выполнения скрипта нам выдаются колонки в терминале с нужными данными оставалось только CTRL-C, CTRL-V.
Результаты тестирования:
Все представленные конфигурации фиксированные, это означает, что время их готовности к работе, при аренде сервера, составит несколько минут они всегда доступны в нашей панели и если интересно вы прямо сейчас можете посмотреть их стоимость и как взять их в аренду (ссылка).
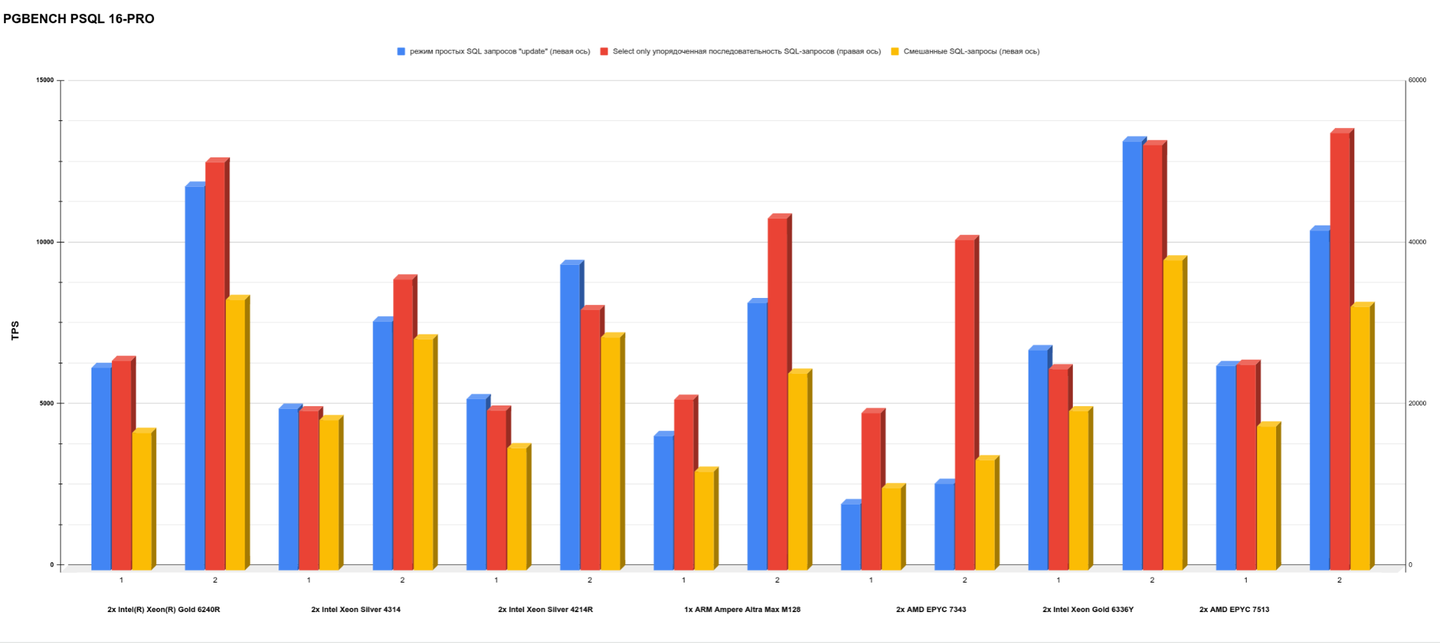
На каждую версию PSQL мы генерили такой график:
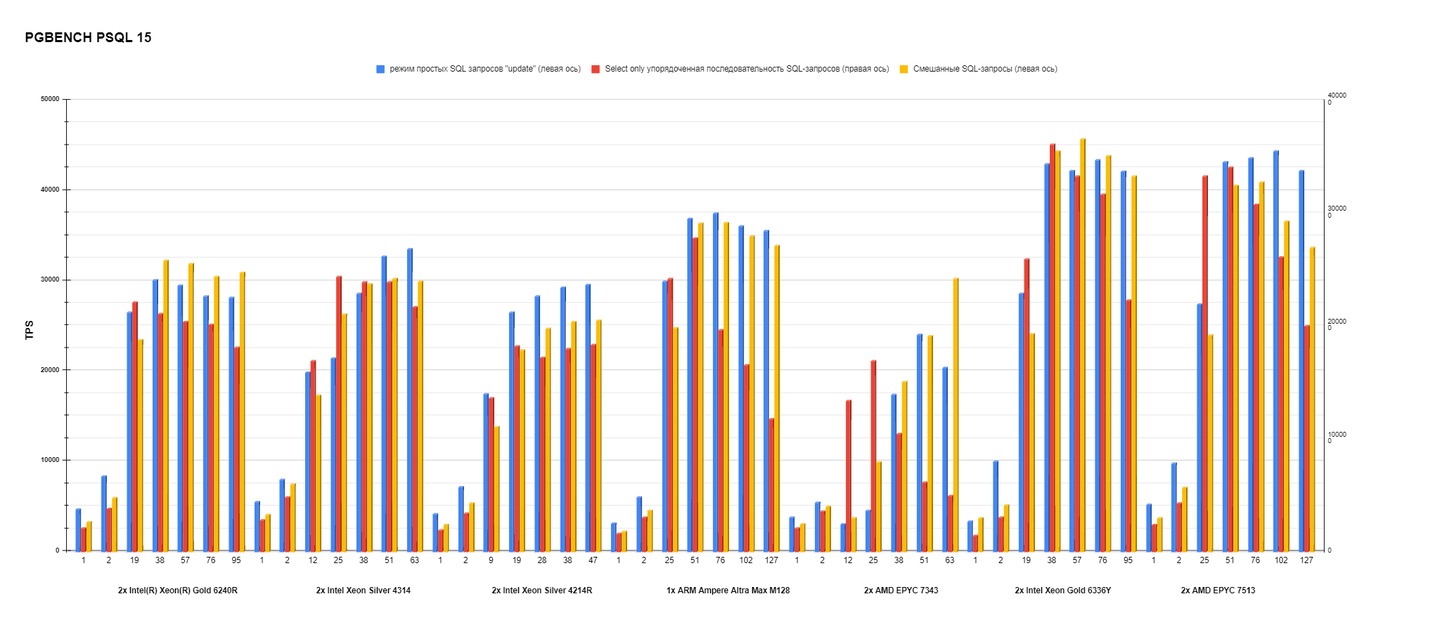
Для оценки производительности в многопоточном режиме, а так же такой график:
Для оценки производительности в одном и двух потоках чтобы оценить (производительность на ядро)
Здесь сразу можно увидеть что процессоры 2го поколения выигрывают у процессоров 3го поколения в производительности на ядро.
главная задача стояла оценить общую производительность PSQL разных версий, об этом графики ниже:
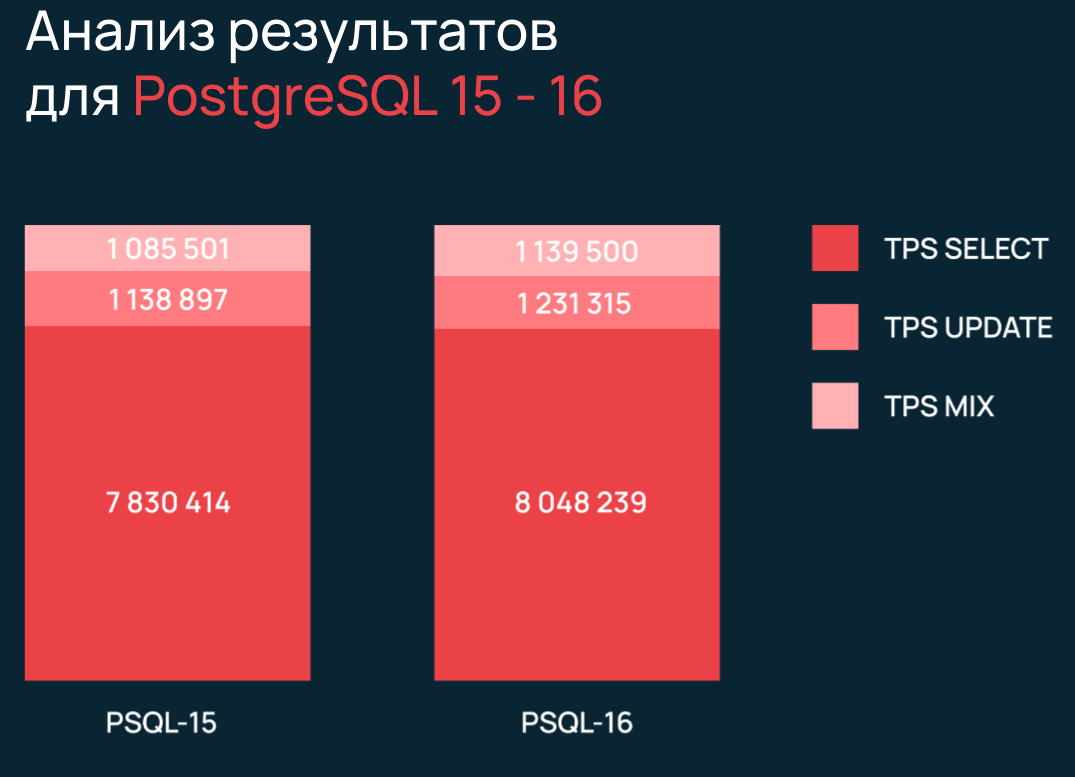
Мы посчитали операции в секунду по каждой платформе и сравнили 15 версию PSQL и 16 версию PSQL (не энтерпрайз)
Получили разницу в производительности от 2 до 7%, значительный разрыв по SELECT ONLY.
Дальше сравниваем PSQL 15-16 PRO:
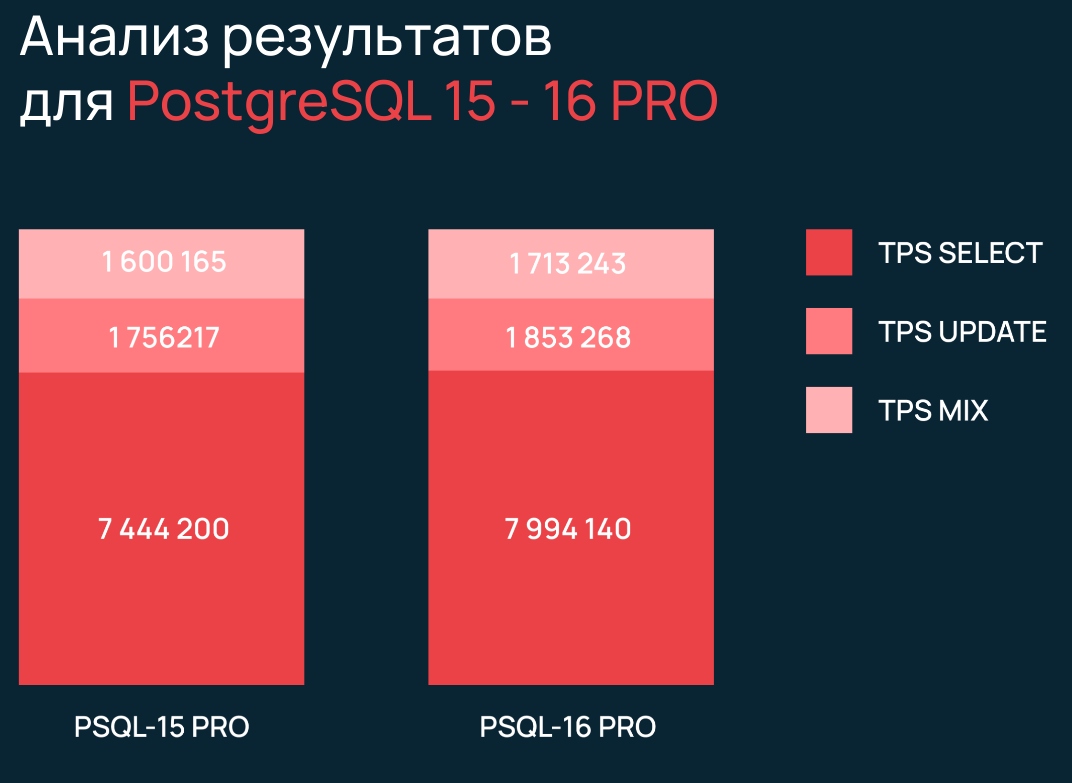
Тут в процентном соотношении результат похож на предыдущий но кол-во операций в секунду здесь гораздо больше чем в обычных версиях PSQL, далее смотрим график с общим сравнением обычных версий и энтерпрайз:
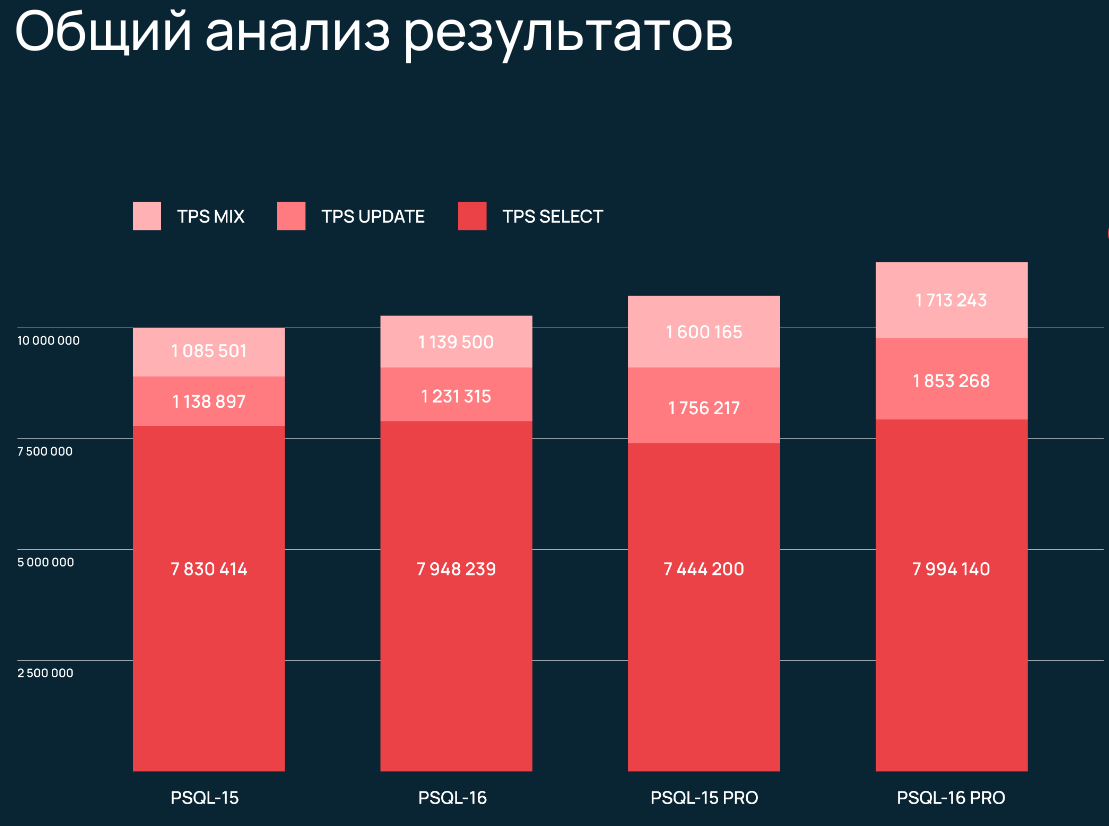
Здесь мы видим значительную разницу между обычной и ПРО версией, одной из причин является автоконфигурирование PSQL в энтерпрайз версиях, которая немного тюнит БД для лучшей производительности (для нас это все равно дефолт, так как из коробки мы ничего не делаем)
Конечно скорее всего под капотом еще много оптимизаций которых мы не видим как обычные пользователи БД.
Далее мы задались вопросом что будет если выжать из железа максимум и настроить БД и конфиг на максимальную производительность и вот что получили:
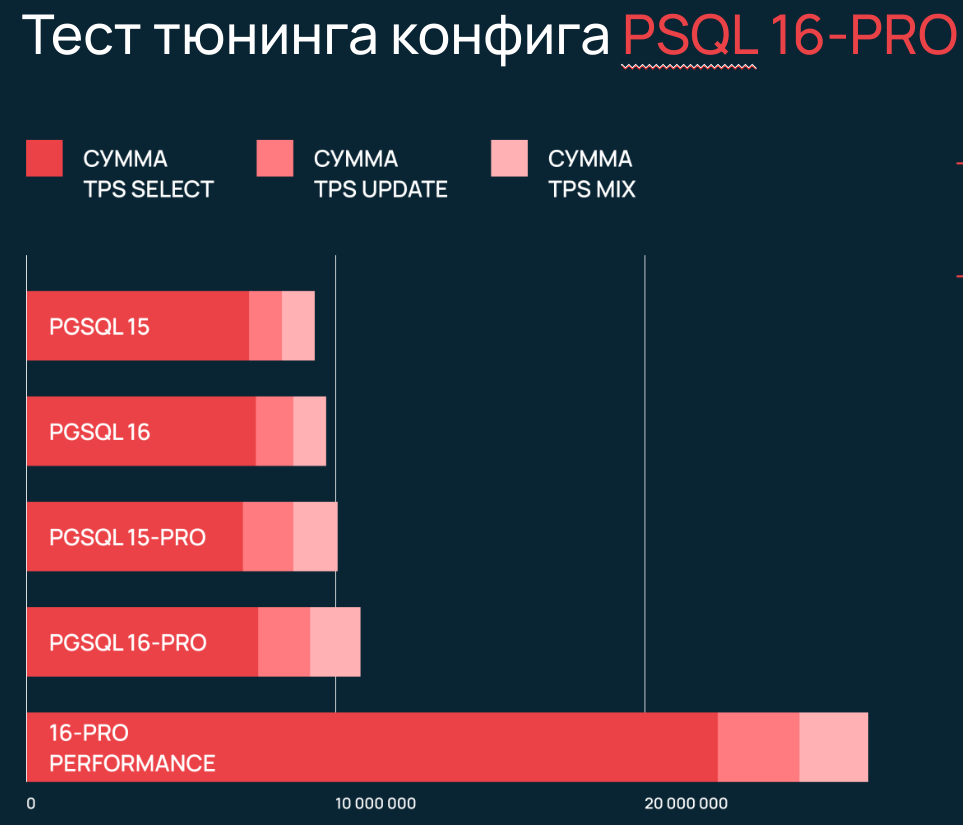
Сверху 4 теста PSQL в дефолтном режиме, самый нижний тест в перфоманс режиме с одними изз возможных максимальных настроек PSQL для производительности, вот что было настроено:
Huge Pages эффективно управляет большим объемом памяти
BG Writer оптимизирует фоновую запись данных на диск
Prefetching улучшение производительности при сканировании данных
Вынесение каталога pg_stat_tmp в RAM (tmpfs)
Autovacuum автоматическая очистка
Write-Ahead Logging — запись перед чтением, увеличивает размер журнала, что позволяет редко выполнять контрольные точки
#Определить количество HugePages. Обычно их размер равен 2MB. Например, нам нужно 3100 страниц.
#Прописать в /etc/sysctl.conf настройку число больших страниц:
systemctl stop psotgresql
#Проверка сколько Huge page надо
sudo -u postgres/opt/pgpro/ent-15/bin/postgres —shared-buffers=2GB -D /var/lib/pgpro/ent-15/data/ -C shared_memory_size_in_huge_pages
systemctl start psotgresql
echo 3100 | sudo tee /proc/sys/vm/nr_hugepages
#Проверяем настройку:
cat /proc/meminfo
#Число HugePages должно быть ненулевое, а общее должно равняться 3100.
#Выключаем настройку THP:
echo never > /sys/kernel/mm/transparent_hugepage/enabled
#Устанавливаем группу для Huge Pages
pg_group_id=$(id -g postgres)
echo "$pg_group_id" | sudo tee /proc/sys/vm/hugetlb_shm_group
sudo sed -i 's/huge_pages = try/huge_pages = on/' /var/lib/pgpro/ent-16/data/postgresql.conf
systemctl restart psotgresql
sudo sed -i "s/^#bgwriter_delay =.*/bgwriter_delay = '10ms'/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#bgwriter_flush_after =.*/bgwriter_flush_after = 0/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#bgwriter_lru_maxpages =.*/bgwriter_lru_maxpages = 4000/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#bgwriter_lru_multiplier =.*/bgwriter_lru_multiplier = 10/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#checkpoint_completion_target =.*/checkpoint_completion_target = 0.9/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#checkpoint_timeout =.*/checkpoint_timeout = '30min'/" /var/lib/pgpro/ent-16/data/postgresql.conf
sudo sed -i "s/^#max_wal_size =.*/max_wal_size = '32GB'/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#wal_compression =.*/wal_compression = 'lz4'/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#default_toast_compression =.*/default_toast_compression = 'lz4'/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#lwlock_shared_limit =.*/lwlock_shared_limit = 16/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#log2_num_lock_partitions =.*/log2_num_lock_partitions = 8/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#slru_buffers_size_factor =.*/slru_buffers_size_factor = 6/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#default_statistics_target =.*/default_statistics_target = 1000/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#autoprepare_threshold =.*/autoprepare_threshold = 2/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#autoprepare_for_protocol =.*/autoprepare_for_protocol = 'simple'/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#generic_plan_fuzz_factor =.*/generic_plan_fuzz_factor = 0.9/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#effective_io_concurrency =.*/effective_io_concurrency = 100/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#autovacuum_naptime =.*/autovacuum_naptime = '1s'/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#autovacuum_max_workers =.*/autovacuum_max_workers = 6/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#vacuum_cost_limit =.*/vacuum_cost_limit = 2000/" /var/lib/pgpro/ent-16/data/postgresql.conf && \
sudo sed -i "s/^#autovacuum_work_mem =.*/autovacuum_work_mem = '1GB'/" /var/lib/pgpro/ent-16/data/postgresql.conf
Скрипт для переноса каталога pg_stat_tmp в RAM-диск
#!/bin/bash
# Путь к RAM-диску
RAMDISK_PATH="/mnt/ramdisk"
# Размер RAM-диска (1GB)
RAMDISK_SIZE="1G"
# Путь к каталогу pg_stat_tmp
PG_STAT_TMP_PATH="/var/lib/pgpro/ent-16/data/pg_stat_tmp"
# Переменная для резервного копирования оригинального каталога
PG_STAT_TMP_BACKUP_PATH="/var/lib/pgpro/ent-16/data/pg_stat_tmp_backup"
# Создание каталога RAM-диска
sudo mkdir $RAMDISK_PATH
# Примонтирование RAM-диска
sudo mount -t tmpfs -o size=$RAMDISK_SIZE tmpfs $RAMDISK_PATH
# Копирование данных из pg_stat_tmp в RAM-диск
sudo cp -r $PG_STAT_TMP_PATH/. $RAMDISK_PATH/
# Создание символической ссылки
sudo mv $PG_STAT_TMP_PATH $PG_STAT_TMP_BACKUP_PATH
sudo ln -s $RAMDISK_PATH $PG_STAT_TMP_PATH
# Проверка создания символической ссылки
ls -l $PG_STAT_TMP_PATH
Итоги
В данном тестирования мы подтвердили для себя что всегда лучше обновиться на новую версию PSQL будь то обычная версия или PRO версия, если мы хотим большей производительности то это PRO версия с тюнингом БД.
Обязательно требуется настраивать BIOS, ОС, и саму БД можно воспользоваться нашими подсказками.