Всем привет, меня зовут Максим, я работаю инженером по тестированию железа в Selectel Lab.
У нас в селектел лаб появился вопрос: как специалисты и другие люди, которые принимают решения о выборе сервера под проект с базами данных, понимают, какой сервер нужен — на что ориентироваться? Частота процессора, количество ядер, скорость дисков или объём и частота оперативной памяти?
Одновременно с этими вопросами нам попали на тест серверы с процессором ARM (Ampere Altra Max M128-30) от компании Gigabyte. Поэтому мы решили прогнать наши фиксированные конфигурации через тесты баз данных и понять: что выгоднее и лучше? Может быть, ARM — тот самый сервер, который всех порвёт? Про первые тесты и впечатления от 80-ядерного ARM можно почитать в статье про Ampere Altra против AMD EPYC.
На данный момент производительность серверов играет ключевую роль в успешности любого IT-проекта. Оптимальная конфигурация сервера может существенно повысить эффективность работы баз данных и обеспечить стабильную работу системы. Расскажем как тестировали различные конфигурации серверов с использованием двух популярных баз данных – PostgreSQL и MySQL.
Конфигурации
Итак, мы выбрали подборку самых популярных и топовых серверов Selectel, чтобы прогнать на них тесты баз данных. Вот их список (в него же входит ARM):
ОС и виды тестов
Использовали Ubuntu 22.10 — на момент тестирования это была последняя версия ОС под ARM и x86. Также взяли самую свежую на тот момент версию PostgreSQL — 14: с её дефолтными настройками в некоторых тестах производительность выросла почти в два раза по сравнению с 12-й версией, и это была последняя версия, доступная под архитектуру ARM. По тем же причинам выбрали 8-ю версию MySQL.
ОС была установлена на NVMe диски. БД так же разворачивалась на них же. Использовали такие тесты как Pgbench, Sysbench, и Mysqlslap.
Тесты проводили с использованием одного и двух потоков постоянно, далее шли тесты 20%, 40%, 60%, 80%, 99% от максимального количества потоков процессора в конкретной конфигурации.
Количество клиентов которые подключались к базе было всегда в 2 раза больше чем количество потоков это сделано из за рекомендаций разработчиков постгрес, так сказать “дефолтные тесты из коробки”.
Подготовка системы и БД
Систему никак не настраивали в плане перфоманса все на дефолтных настройках. То же самое и с настройками постгреса только правка конфига на подключение и количество подключений к БД. Пытались свести к минимуму количество настроек что бы тест был более объективным. Все тесты проводили локально непосредственно на сервере, где находилась БД. Чтобы исключить влияние сетевых погрешностей и пропускной способности.
Так разворачивали софт:
#!/bin/bash
# Устанавливаем пароль для пользователя "admin"
admin_password="passwd"
# Устанавливаем PostgreSQL-14
apt install postgresql-14 sysbench
# Изменяем конфигурационный файл PostgreSQL
cd /etc/postgresql/14/main/
sed -i -e "s/^#\?\s*listen_addresses\s*[=]\s*[^\t#]*/listen_addresses = '127.0.0.1'/" postgresql.conf
sed -i -e "/^max_connections/s/[= ][^\t#]*/ = '300'/" postgresql.conf
service postgresql restart
# Создаем базу данных "test"
sudo -u postgres createdb test
# Создаем пользователя "admin" с установленным паролем
echo "admin:$admin_password" | sudo chpasswd
sudo -u postgres createuser admin
sudo -u postgres psql -d test -c "ALTER USER admin WITH PASSWORD '$admin_password';"
# Добавляем информацию о подключении к базе данных в файл.pgpass
cat >> /home/admin/.pgpass<<EOF
127.0.0.1:5432:test:admin:$admin_password
EOF
chmod 0600 /home/admin/.pgpass
chown admin:admin /home/admin/.pgpass
Тут всё довольно просто: ставим PostgreSQL, правим конфиг, создаём базу, задаём пароль. Один нюанс — для тестов pgbench нужен файл pgpass, чтобы не вводить пароль на каждой итерации теста; это для удобства и автоматизации.
Развертывание MYSQL:
#!/bin/bash
# Устанавливаем пароль для пользователя "admin" MySQL
mysql_password="passwd"
# Устанавливаем MySQL-сервер 8.0 и Sysbench
apt install mysql-server-8.0 sysbench
# Изменяем конфигурационный файл MySQL
cd /etc/mysql/mysql.conf.d/
sed -i -e "/^bind-address/s/[= ][^\t#]*/ = '127.0.0.1'/" mysqld.cnf
sed -i -e "/^mysqlx-bind-address/s/[= ][^\t#]*/ = '127.0.0.1'/" mysqld.cnf
sed -i -e "s/^#\?\s*max_connections\s*[=]\s*[^\t#]*/max_connections = '300'/" mysqld.cnf
service mysql restart
# Создаем базу данных "test" и пользователя "admin" с установленным паролем
echo "CREATE DATABASE test;" | mysql
echo "USE test;" | mysql
echo "CREATE USER 'admin'@'localhost' IDENTIFIED BY '$mysql_password';" | mysql
echo "GRANT ALL ON *.* TO 'admin'@'localhost' WITH GRANT OPTION;" | mysql
Автоматизация теста pgbench
Набросал скрипт, чтобы каждый раз не считать количество потоков и не менять его руками — так часто закрадываются ошибки. Один нюанс: при тестировании на ARM-платформе дистрибутив Ubuntu 22.10 под ARM не содержит предустановленного пакета «bc».
 #!/bin/bash
read -p "Введите максимальное количество потоков: " CORES
if! [[ "$CORES" =~ ^[0-9]+$ ]] || [[ "$CORES" -le 0 ]]; then
echo "Ошибка ввода, введите положительное значение."
exit 1
fi
HOST="127.0.0.1"
TIME="600"
# Создаем базу данных
pgbench —username=admin -h "${HOST}" test -i -s 10000
THREADS=(1 2 $(echo "scale=0; $CORES * 20 / 100" | bc -l) \
$(echo "scale=0; $CORES * 40 / 100" | bc -l) \
$(echo "scale=0; $CORES * 60 / 100" | bc -l) \
$(echo "scale=0; $CORES * 80 / 100" | bc -l) \
$(echo "scale=0; $CORES * 99 / 100" | bc -l))
USERS=()
for THREAD in "${THREADS[@]}"
do
USER=$((THREAD * 2))
USERS+=($USER)
done
FILE=test.txt
# Запускаем тесты с одним и двумя потоками
for i in {0..1}
do
PARAM="-j ${THREADS[$i]} -c ${USERS[$i]}"
echo "pgbench —username=admin -h ${HOST} test ${PARAM} -T ${TIME}" >> "${FILE}"
pgbench —username=admin -h "${HOST}" test "${PARAM}" -T "${TIME}" >> "${FILE}"
echo "pgbench —username=admin -h ${HOST} test ${PARAM} -S -T ${TIME}" >> "${FILE}"
pgbench —username=admin -h "${HOST}" test "${PARAM}" -S -T "${TIME}" >> "${FILE}"
echo "pgbench —username=admin -h ${HOST} test ${PARAM} -N -T ${TIME}" >> "${FILE}"
pgbench —username=admin -h "${HOST}" test "${PARAM}" -N -T "${TIME}" >> "${FILE}"
done
# Запускаем тесты с 20%, 40%, 60%, 80%, 99% потоков
for i in {2..6}
do
PARAM="-j ${THREADS[$i]} -c ${USERS[$i]}"
echo "pgbench —username=admin -h ${HOST} test ${PARAM} -T ${TIME}" >> "${FILE}"
pgbench —username=admin -h "${HOST}" test "${PARAM}" -T "${TIME}" >> "${FILE}"
echo "pgbench —username=admin -h ${HOST} test ${PARAM} -S -T ${TIME}" >> "${FILE}"
pgbench —username=admin -h "${HOST}" test "${PARAM}" -S -T "${TIME}" >> "${FILE}"
echo "pgbench —username=admin -h ${HOST} test ${PARAM} -N -T ${TIME}" >> "${FILE}"
pgbench —username=admin -h "${HOST}" test "${PARAM}" -N -T "${TIME}" >> "${FILE}"
done
exit 0
Изначально на первых тестах скрипт выглядел так:
#!/bin/bash
pgbench —username=admin -h 127.0.0.1 test -i -s 10000
FILE=test.txt
for PARAM in "-c 2 -j 1" "-c 4 -j 2" "-c 52 -j 26" "-c 104 -j 52" "-c 154 -j 77" "-c 206 -j 103" "-c 254 -j 127"
do
##TPC-B (sort of)
echo "pgbench —username=admin -h 127.0.0.1 test $PARAM -T 600" >> $FILE
pgbench —username=admin -h 127.0.0.1 test $PARAM -T 600 >> $FILE
##select only
echo "pgbench —username=admin -h 127.0.0.1 test $PARAM -S -T 600" >> $FILE
pgbench —username=admin -h 127.0.0.1 test $PARAM -S -T 600 >> $FILE
##simple update
echo "pgbench —username=admin -h 127.0.0.1 test $PARAM -N -T 600" >> $FILE
pgbench —username=admin -h 127.0.0.1 test $PARAM -N -T 600 >> $FILE
done
exit 0
Но когда потребовалось протестировать, много конфигурации с разным количеством потоков стало неудобно править каждый раз скрипт. Так как при разных количествах потоков например приходилось высчитывать сколько будет 20% от 128 потоков и вносить в скрипт, это отнимало время. Также мы задумались о будущих тестированиях других конфигов, и добавили переменные в скрипт чтобы было удобно менять: время тестирования, адрес подключения к БД, пароль и тд.
Как вы можете видеть в pgbench тесте используется 3 ключа для тестирования “-Т”, “-S -T”, “-N -T”.
-Т — Смешанные SQL-запросы (Select, Update)
-S -T — упорядоченная последовательность SQL-запросов (Select only)
-N -T — режим простых SQL запросов запросы (Update only)
Автоматизация теста sysbench (postgresql-MYSQL)
#!/bin/bash
FILE=sysbench.txt
# Запрашиваем максимальное количество потоков
echo "Введите максимальное количество потоков:"
read MAX_THREADS
# Задаем параметры подключения к БД и время тестирования
USER=admin
HOST=127.0.0.1
PORT=5432
PASWD=passwd
DB=test
TIME=600
# Запускаем тесты на 1 и 2 потоках
for THREADS in 1 2
do
for TEST in 'oltp_read_only.lua' 'oltp_write_only.lua' 'oltp_read_write.lua'
do
sysbench —db-driver=pgsql —pgsql-host=$HOST —pgsql-port=$PORT —pgsql-user=$USER —pgsql-password=$PASWD —pgsql-db=$DB —time=$TIME —threads=$THREADS "/usr/share/sysbench/$TEST" prepare
echo "sysbench —db-driver=pgsql —pgsql-host=$HOST —pgsql-port=$PORT —pgsql-user=$USER —pgsql-password=$PASWD —pgsql-db=$DB —time=$TIME —threads=$THREADS \"/usr/share/sysbench/$TEST\"" >> $FILE
sysbench —db-driver=pgsql —pgsql-host=$HOST —pgsql-port=$PORT —pgsql-user=$USER —pgsql-password=$PASWD —pgsql-db=$DB —time=$TIME —threads=$THREADS "/usr/share/sysbench/$TEST" run >> $FILE
sysbench —db-driver=pgsql —pgsql-host=$HOST —pgsql-port=$PORT —pgsql-user=$USER —pgsql-password=$PASWD —pgsql-db=$DB —time=$TIME —threads=$THREADS "/usr/share/sysbench/$TEST" cleanup
done
done
# Определяем количество потоков для каждого теста
for i in 20 40 60 80 99
do
# Вычисляем количество потоков для текущего теста
THREADS=$(echo "scale=0; $MAX_THREADS*$i/100" | bc)
for TEST in 'oltp_read_only.lua' 'oltp_write_only.lua' 'oltp_read_write.lua'
do
# Запускаем тест
sysbench —db-driver=pgsql —pgsql-host=$HOST —pgsql-port=$PORT —pgsql-user=$USER —pgsql-password=$PASWD —pgsql-db=$DB —time=$TIME —threads=$THREADS "/usr/share/sysbench/$TEST" prepare
echo "sysbench —db-driver=pgsql —pgsql-host=$HOST —pgsql-port=$PORT —pgsql-user=$USER —pgsql-password=$PASWD —pgsql-db=$DB —time=$TIME —threads=$THREADS \"/usr/share/sysbench/$TEST\"" >> $FILE
sysbench —db-driver=pgsql —pgsql-host=$HOST —pgsql-port=$PORT —pgsql-user=$USER —pgsql-password=$PASWD —pgsql-db=$DB —time=$TIME —threads=$THREADS "/usr/share/sysbench/$TEST" run >> $FILE
sysbench —db-driver=pgsql —pgsql-host=$HOST —pgsql-port=$PORT —pgsql-user=$USER —pgsql-password=$PASWD —pgsql-db=$DB —time=$TIME —threads=$THREADS "/usr/share/sysbench/$TEST" cleanup
done
done
Тут примерно так же как и в pgbench но с отличиями, так как пароль надо указывать в скрипте выполнения, по этому добавил переменную passwd. Так же для удобства добавил переменные, TIME, HOST, PORT, DB, USER, чтобы не менять их в каждой строчке. Определяем количество потоков исходя из поставленных условий 1,2, потока не изменяемый параметр, далее 20, 40, 60, 80, 99% от максимального кол-ва потоков.
Тест MYSQLSLAP
Автоматизацию теста mysqlslap делать не стали так как не понятно будем ли мы его использовать в дальнейшем.
Скрипт выполнения такой:
#!/bin/bash
FILE=mysqlslap.txt
for THREADS in 1 2 26 52 77 103 127
do
mysqlslap —auto-generate-sql —concurrency=$THREADS —iterations=1 —number-of-queries=100000 >> $FILE
done
exit 0
В данном тесте указывается на какое количество клиентов разбивается количество запросов (queries), метрика теста — время выполнения запросов.
Парсинг результатов в гугл таблицу.
После каждого теста у нас создавался.txt файл с большим количеством текста в котором зарыты нужные нам числа и результаты, вот пример скрипта которым я собирал данные и заносил в гугл таблицу:
#!/usr/bin/awk -f
BEGIN {
# Параметры таблицы, выравнивание
client_width = 10
thread_width = 12
tps_width = 20
trans_width = 20
latency_width = 20
init_conn_width = 25
# Вывод столбцов
printf "%-s%-s%-s%-s%-s%-s\n", "Num Clients", "Num Threads", "TPS", "Num Transactions", "Latency Average", "Initial Connection Time"
}
# Извлечение нужных значений из строки запуска pgbench
match($0, /-j\s+([0-9]+)/, arr) {
num_clients = arr[1]
}
match($0, /-c\s+([0-9]+)/, arr) {
num_threads = arr[1]
}
# Поиск по строкам нужных значений
/number of transactions actually processed:/ {
num_transactions = $NF
}
/latency average/ {
latency_average = $(NF-1) " " $NF
}
/initial connection time.*[0-9]+\.[0-9]+/ {
# Извлечение только числовых значений
for (i = 1; i <= NF; i++) {
if ($i ~ /^[0-9]+\.[0-9]+$/) {
init_conn_time = $i " " $(i+1)
break
}
}
}
/tps/ {
# Извлечение всех знаков (if present)
for (i = 1; i <= NF; i++) {
if ($i == "tps") {
tps = $(i+2)
gsub(/[()]/, "", tps) # Удаление TPS знач
break
}
}
# Вывод
printf "%-*s%-*s%-*s%-*s%-*s%-*s\n", client_width, num_clients, thread_width, num_threads, tps_width, tps, trans_width, num_transactions, latency_width, latency_average, init_conn_width, init_conn_time
}
в результате выполнения скрипта нам выдаются колонки в терминале с нужными данными оставалось только CTRL-C, CTRL-V.
Результаты тестирования:
Ниже будет очень много диаграмм с результатами, более структурировано визуализировать пока не получилось))
Возможно в будущем мы пересмотрим данную визуализацию и прибегнем к помощи Apache superset например, так как время было ограничено довольствуемся чем есть, диаграммы составлены в гугл таблицах. Было бы на пару конфигов больше и сюда точно бы ничего не влезло.
Все представленные конфигурации фиксированные, это означает, что время их готовности к работе, при аренде сервера, составит несколько минут за исключением custom конфига с двумя процессорами Xeon 6354 данный конфиг можно собрать у нас в конфигураторе в панели my.selectel.ru. Остальные конфиги фиксированные они всегда доступны в нашей панели и если интересно вы прямо сейчас можете посмотреть их стоимость и как взять их в аренду (ссылка).
Мы умышленно не указывали наименования процессоров в диаграммах так как, все таки тестируем полностью собранные серверы и оцениваем их производительность. Если интересует конкретная конфигурация можно посмотреть расшифровку в таблице сверху.
Результаты pgbench postgresql
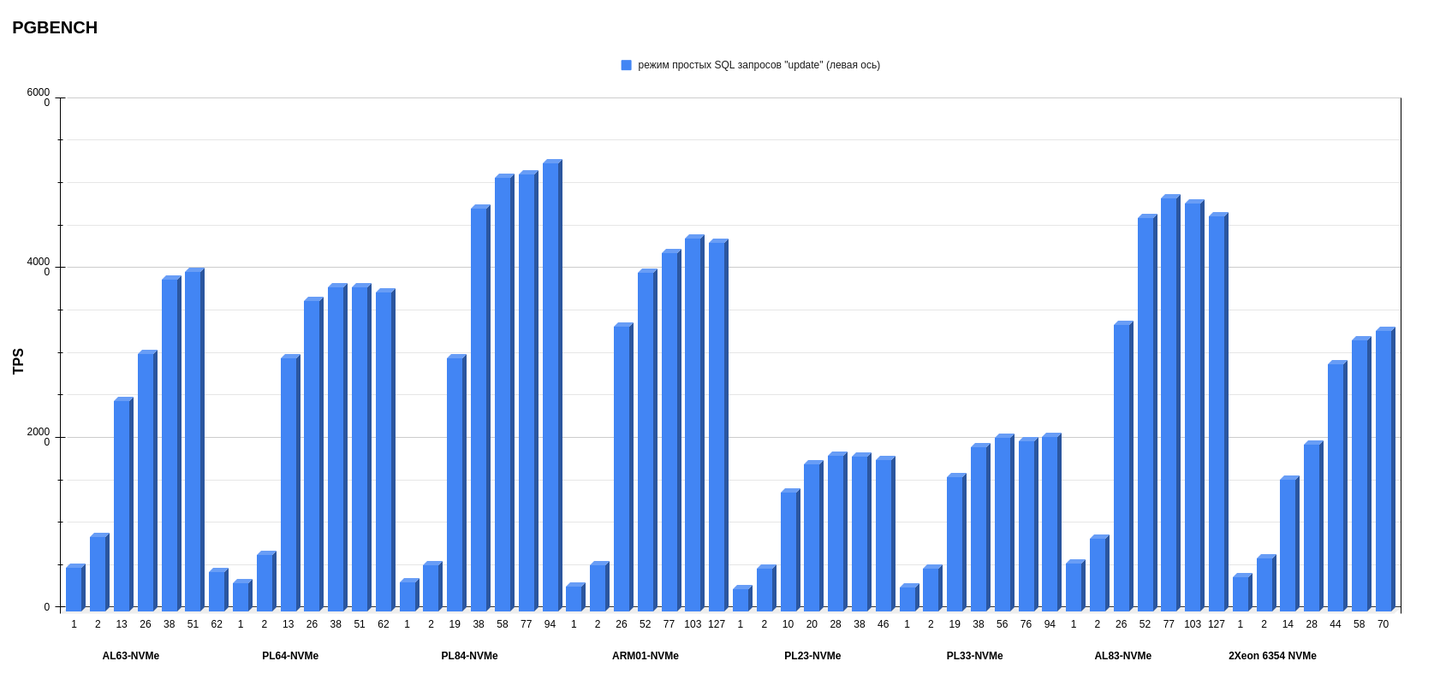
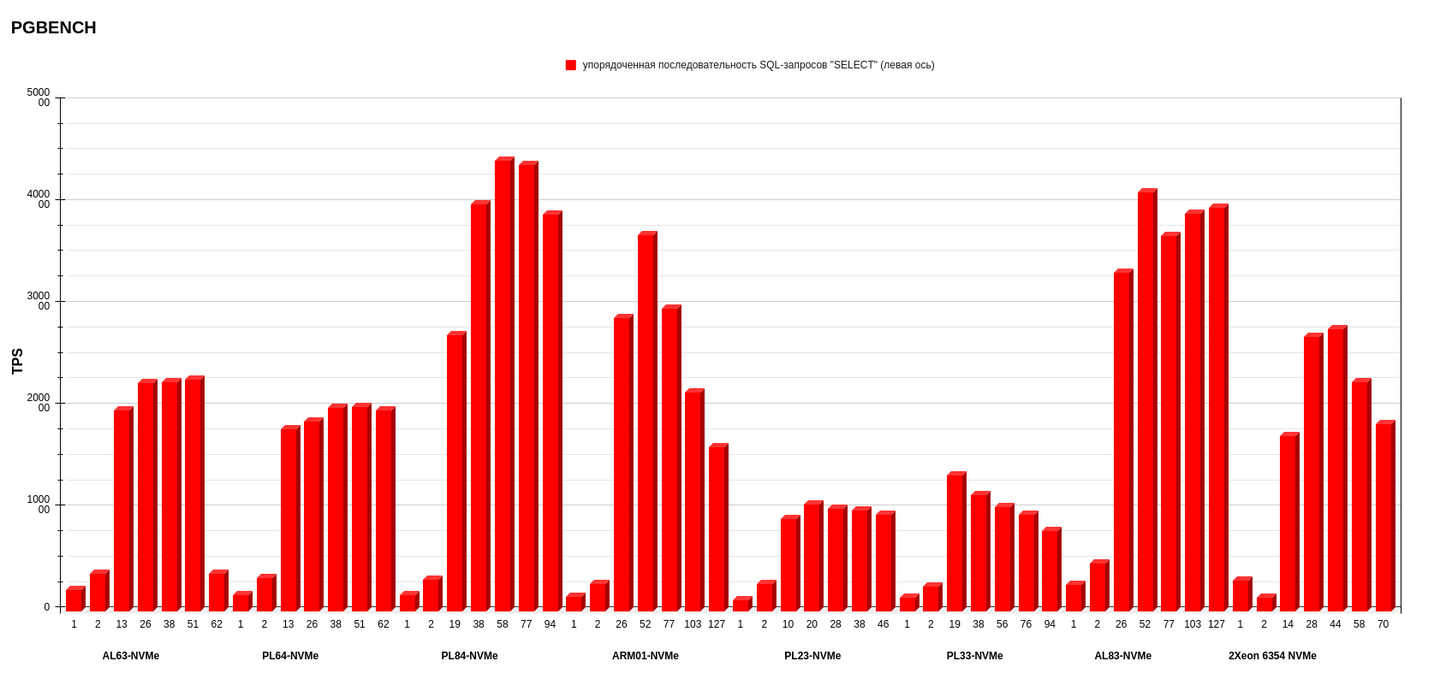
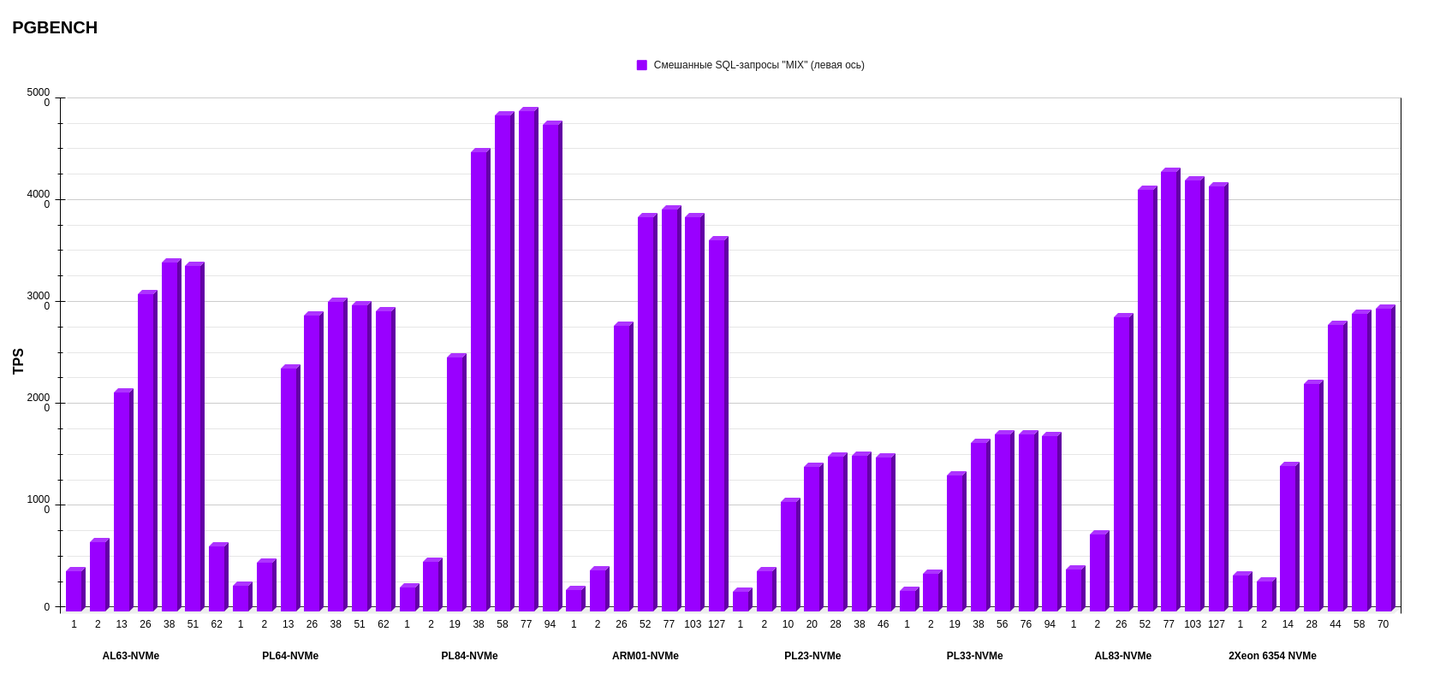
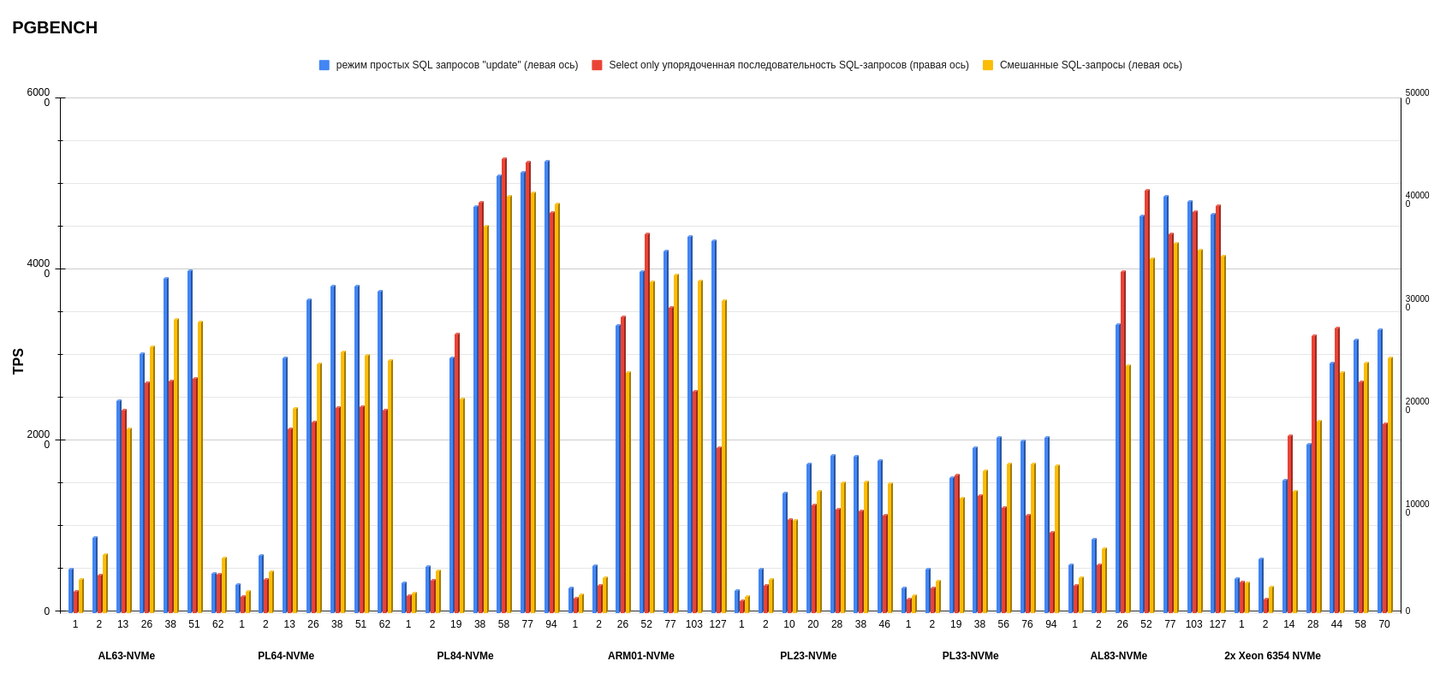
Показатели измеряли в транзакциях в секунду.
Все конфигурации за исключением ARM01 имеют по два сокета и CPU. В ARM01 один сокет, процессор Ampere Altra Max M128-30 на 128 ядер. По графику видно что АРМу можно смело отдать третье место по общей производительности в pgbench а если сделать акцент на то что это один процессор, то первое! Так как мы предполагаем что если бы у конфигурации ARM01 было 2 процессора, то скорее всего он бы всех победил. Спойлер мы это обязательно выясним))). На втором месте по среднему результату у нас конфигурация AL83-NVME-10GE c процессорами 2 × AMD EPYC 7513. И на первом месте с небольшим отрывом от АМД так как количество потоков меньше чем у AL83, побеждает PL84-NVMe c процессорами 2 × Intel Xeon Gold 6336Y.
Краткий анализ диаграмм pgbench: можно интерпретировать следующим образом: у ARM конфигурации с одним процессором, видно что в режиме запросов к БД “Select only”, показания TPS при увеличении количества потоков падают, чего нет в других графиках x86 платформ, я могу связать это с несколькими возможными причинами, которые придется в дальнейшем выяснить. Повторюсь что это лишь предположение.
Баланс между энергопотреблением и производительностью: ARM-процессоры традиционно ориентированы на энергоэффективность и более низкое энергопотребление, что может привести к компромиссу в производительности, особенно при большой нагрузке. В данных тестах мы использовали дефолтные настройки. В АРМ платформе есть параметр отвечающий за снижение тактовой частоты процессора для энергоэффективности (мы его не отключали).
Параллелизм: x86 имеет многопоточность на уровне инструкций (instruction-level parallelism, ILP), что позволяет выполнять несколько инструкций одновременно, в то время как ARM, имеет конвейер команд который оптимизирован по другому в отличии от х86 архитектуры. Это может привести к разнице в производительности, особенно когда количество потоков увеличивается. Мы видим как при 26 потоках ARM процессор показывает примерно такие же результаты как 2 × Intel Xeon Gold 6336Y при 19 потоках, то есть в данном случаем ARM пытается брать количеством ядер, так как у АРМ 1 ядро — 1 поток, когда x86 берет многопоточностью.
Генерация нагрузки (запросов к БД) происходила на том же сервере где и находится тестируемая БД
В любом случае можно говорить о показателях АРМ платформы как о потенциально перспективных и выгодных, учитывая что в данных тестах используется один процессор это уже говорит о многообещающем будущем АРМ архитектуры.
Результаты sysbench postgresql
Здесь график будет иным так как разброс в цифрах очень большой и более информативны графики будут по отдельности: режимы (READ, WRITE, MIX)
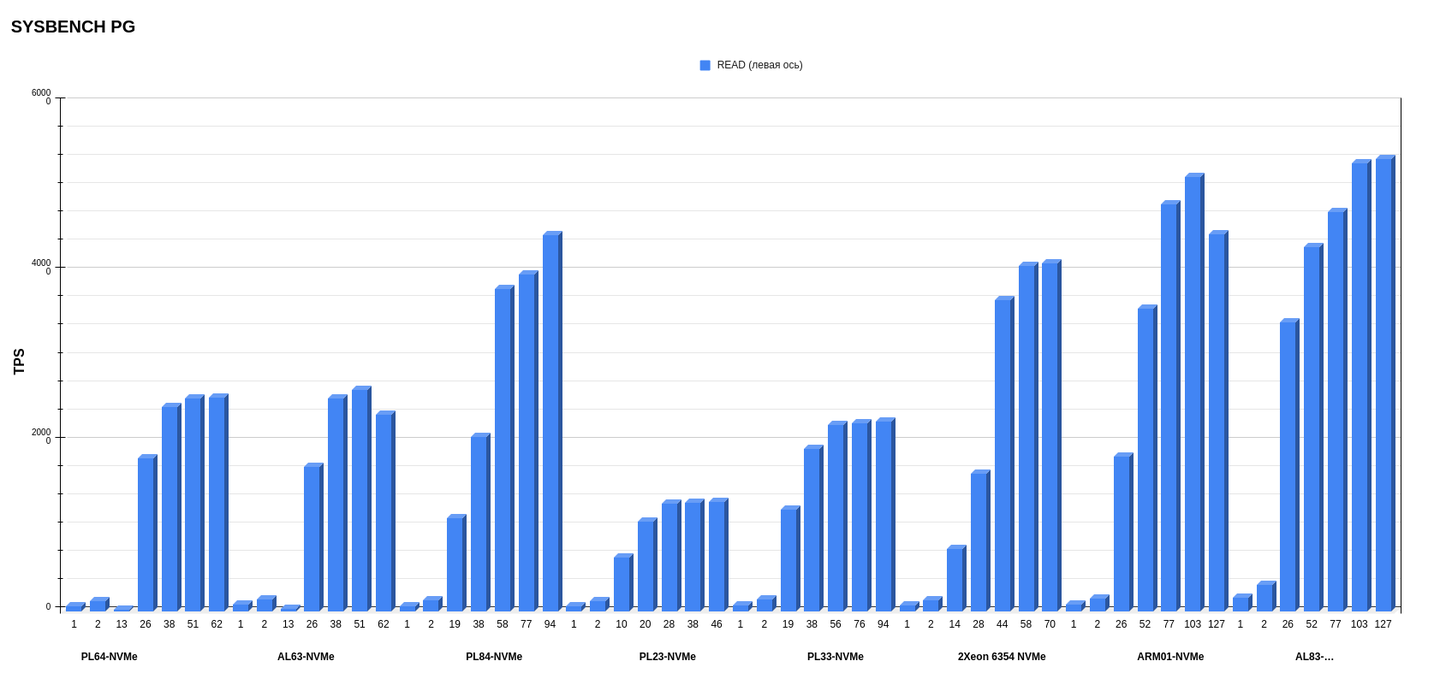
Тут интересный момент с АРМ процессором, видно что у всех конфигураций при достижении “потолка” пропускной способности сохраняются стабильные значения до достижения максимального количества потоков, в то же время как у АРМ значительная просадка при 127 потоках, возможно все так же, причина в том что АРМ не может выполнять несколько инструкций одновременно на одном ядре.
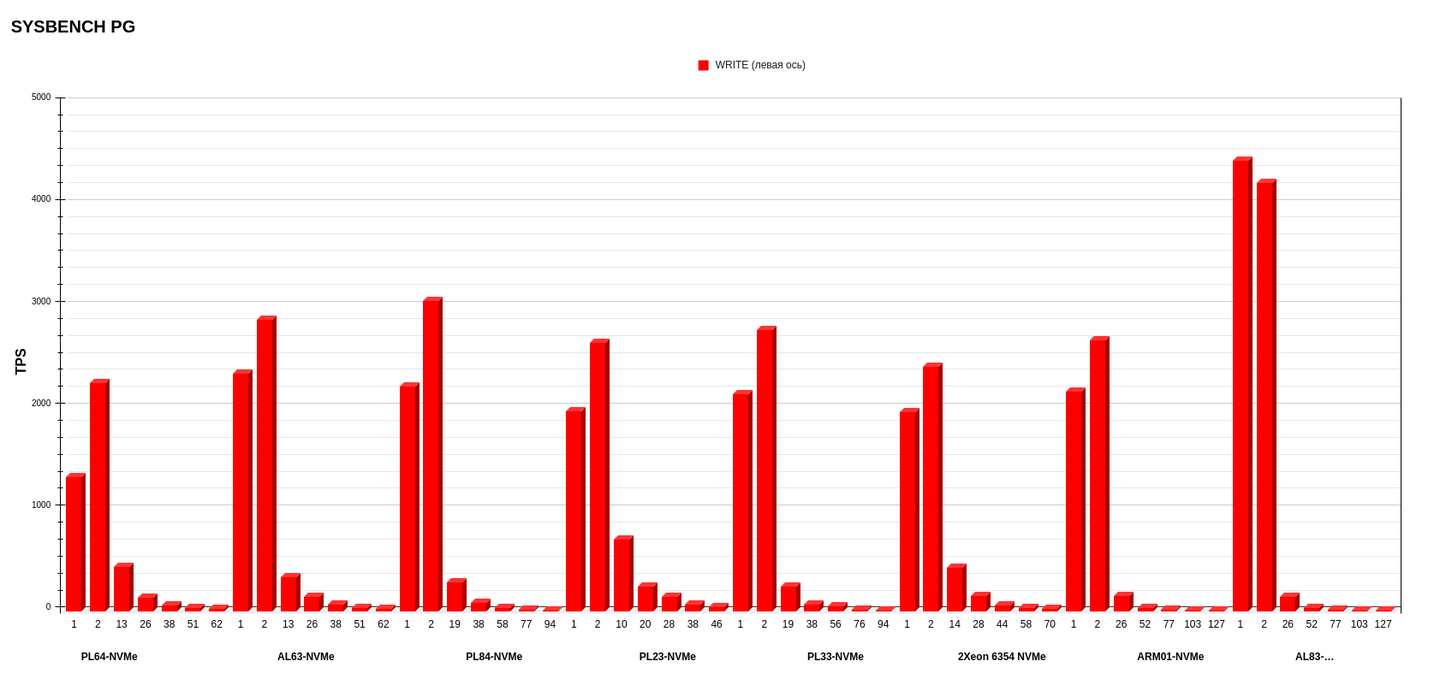
В данной диаграмме видно что при увеличении кол-ва потоков происходит деградация производительности по причине дефолтных настроек postgresql, при которых запись update ведется напрямую на диск.
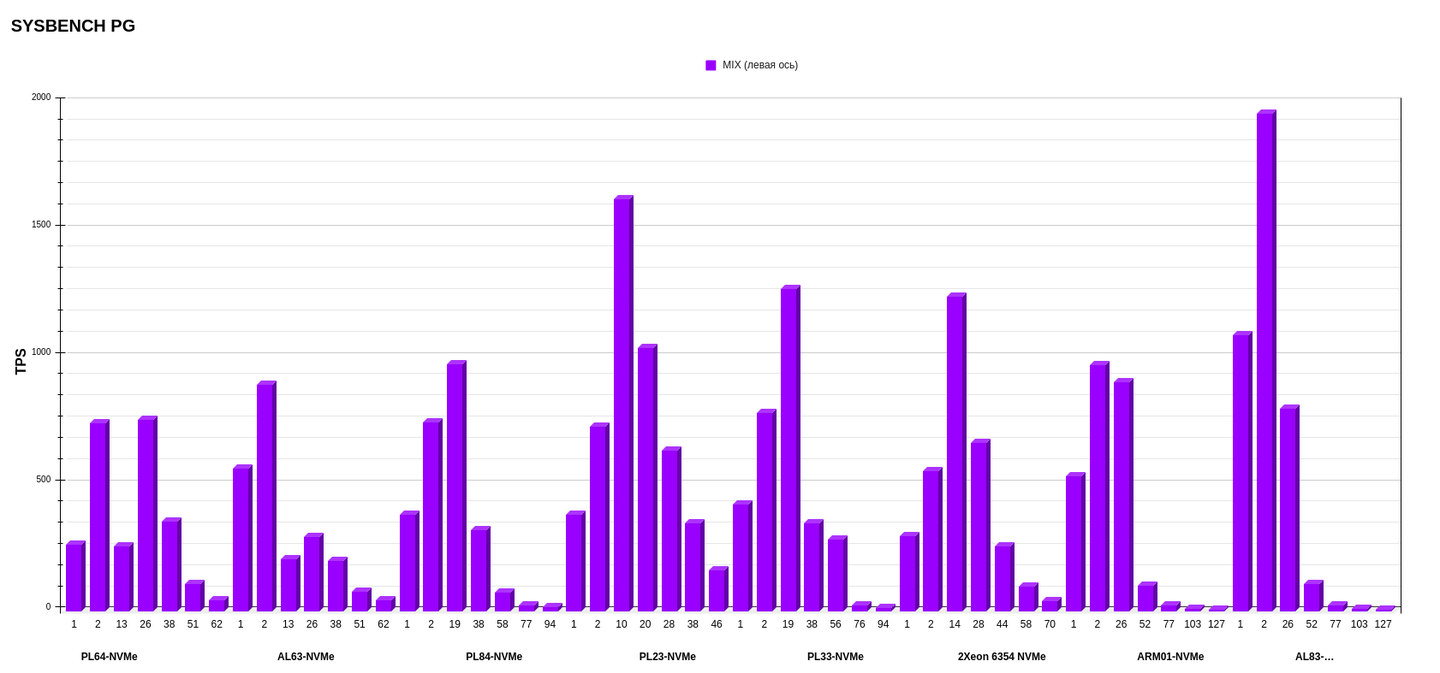
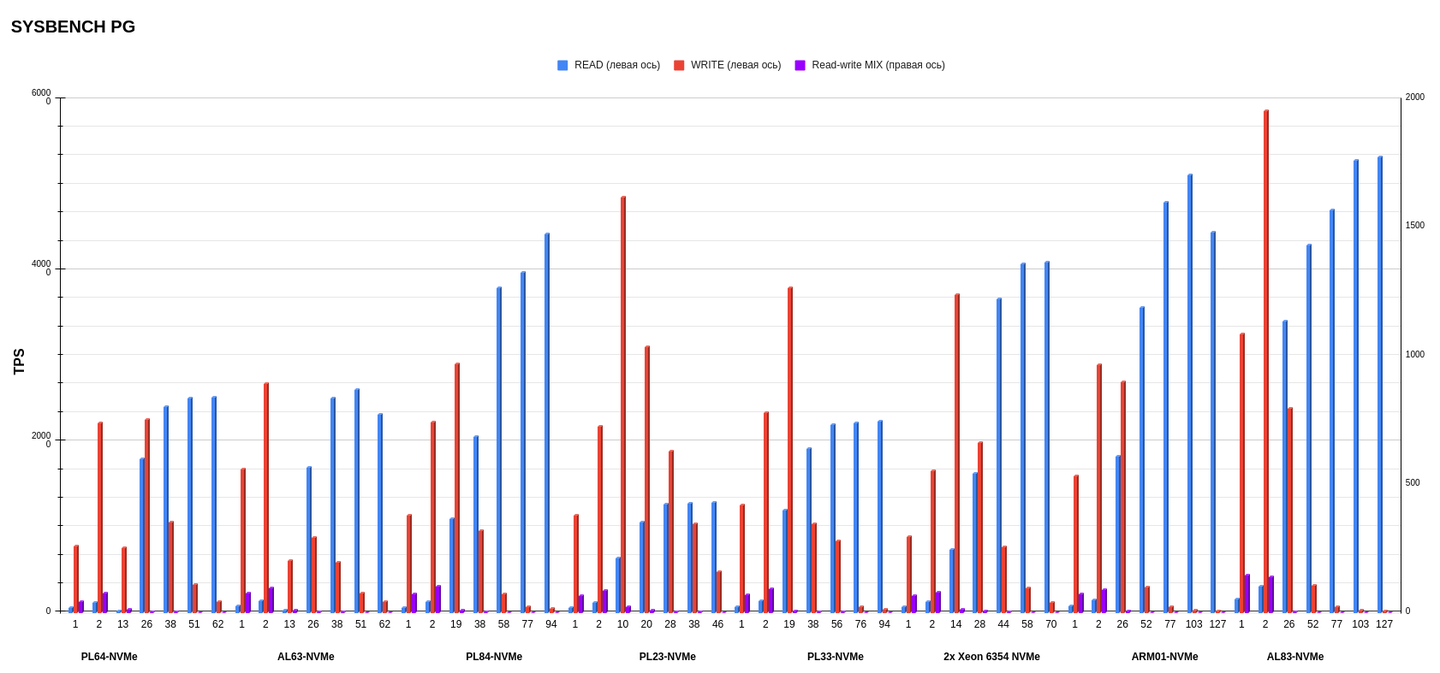
В Sysbench ситуация другая в операциях чтения лидирует AL 83 с AMD EPYC 7513 второе место у ARM01 c Ampere Altra Max M128-30 и 3е место делят Custom конфигурация с Xeon 6354 и PL84 с Intel Xeon Gold 6336Y
По операциям записи со значительным отрывом первое место у AL 83 с AMD EPYC 7513, второе у PL84 с Intel Xeon Gold 6336Y и третье у AL63 с AMD EPYC 7343.
В данном случаем результаты не сильно отличаются по платформам за исключением AL 83 с AMD EPYC 7513.
По результатам read/write mix режима интереснее результаты тут лучше себя показал все так же AL 83 с AMD EPYC 7513 а вот второе и третье место PL23 c Intel Xeon Silver 4214R и PL33 c Intel Xeon Gold 6240R что довольно интересно так как это процессоры второго поколения.
Возможно оптимизация микроархитектуры процессоров второго поколения может быть оптимизирована таким образом, что она лучше справляется с равномерным распределением операций чтения и записи. В этом случае, процессоры второго поколения могут демонстрировать лучшую производительность, если рабочая нагрузка хорошо сбалансирована между операциями чтения и записи.
Результаты MYSQL sysbench
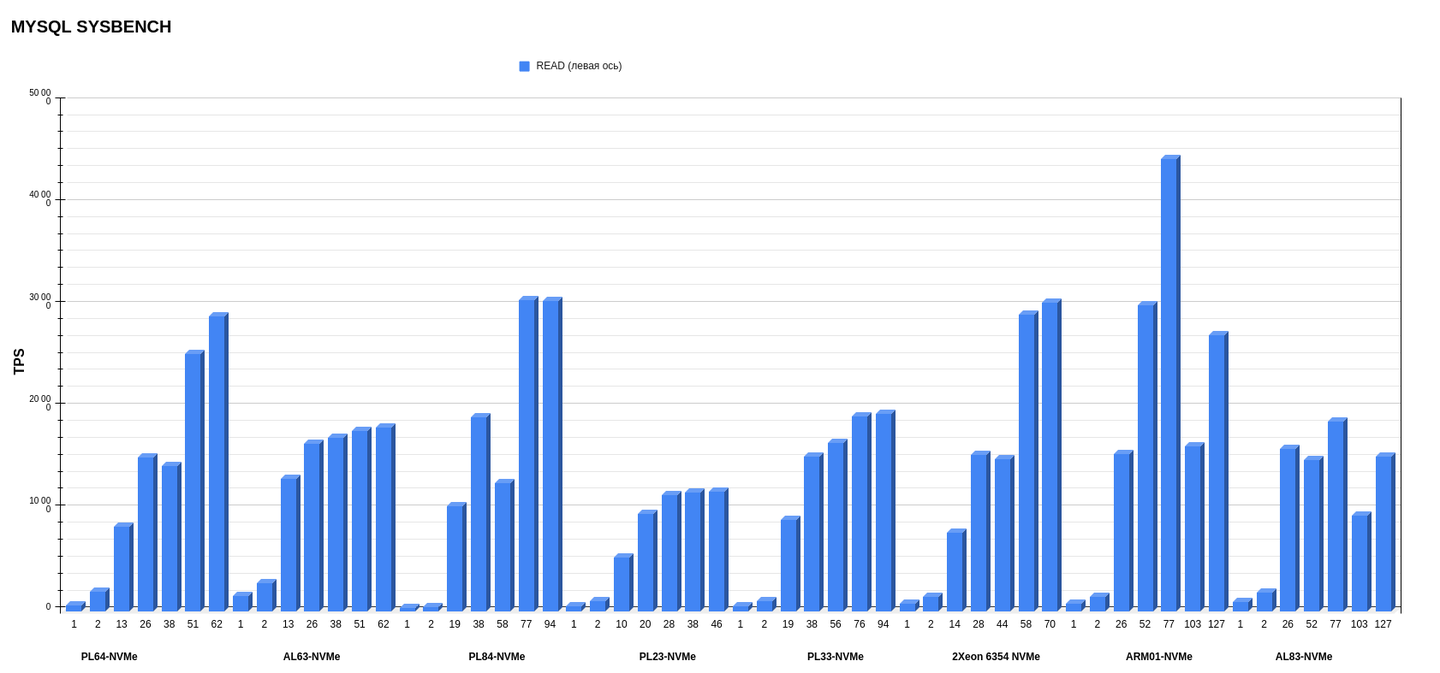
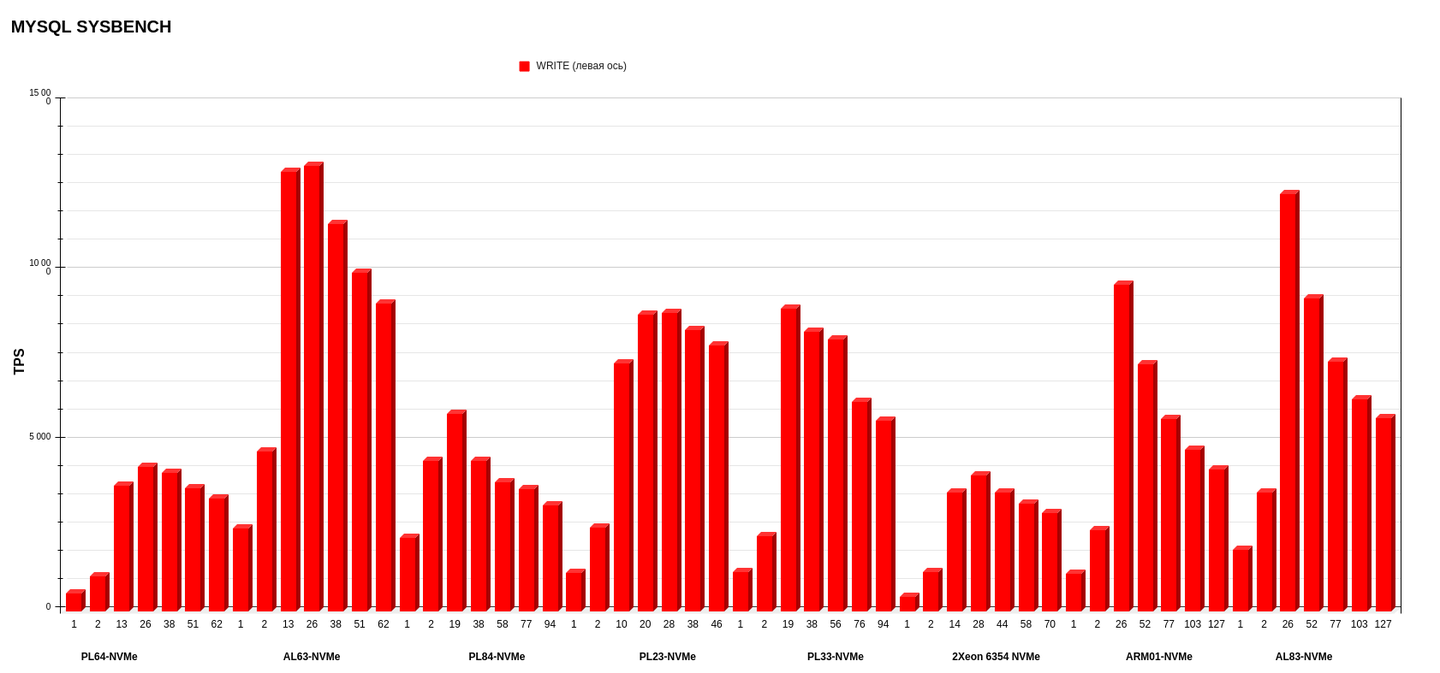
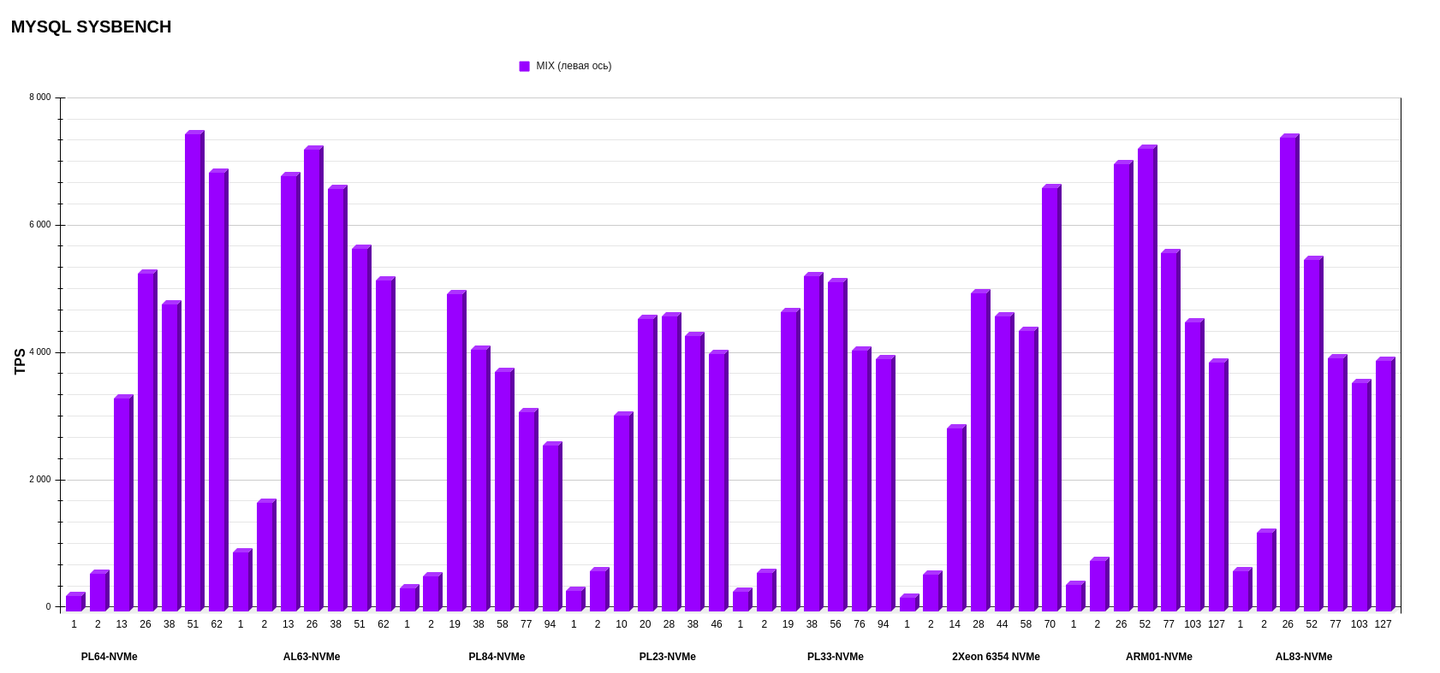
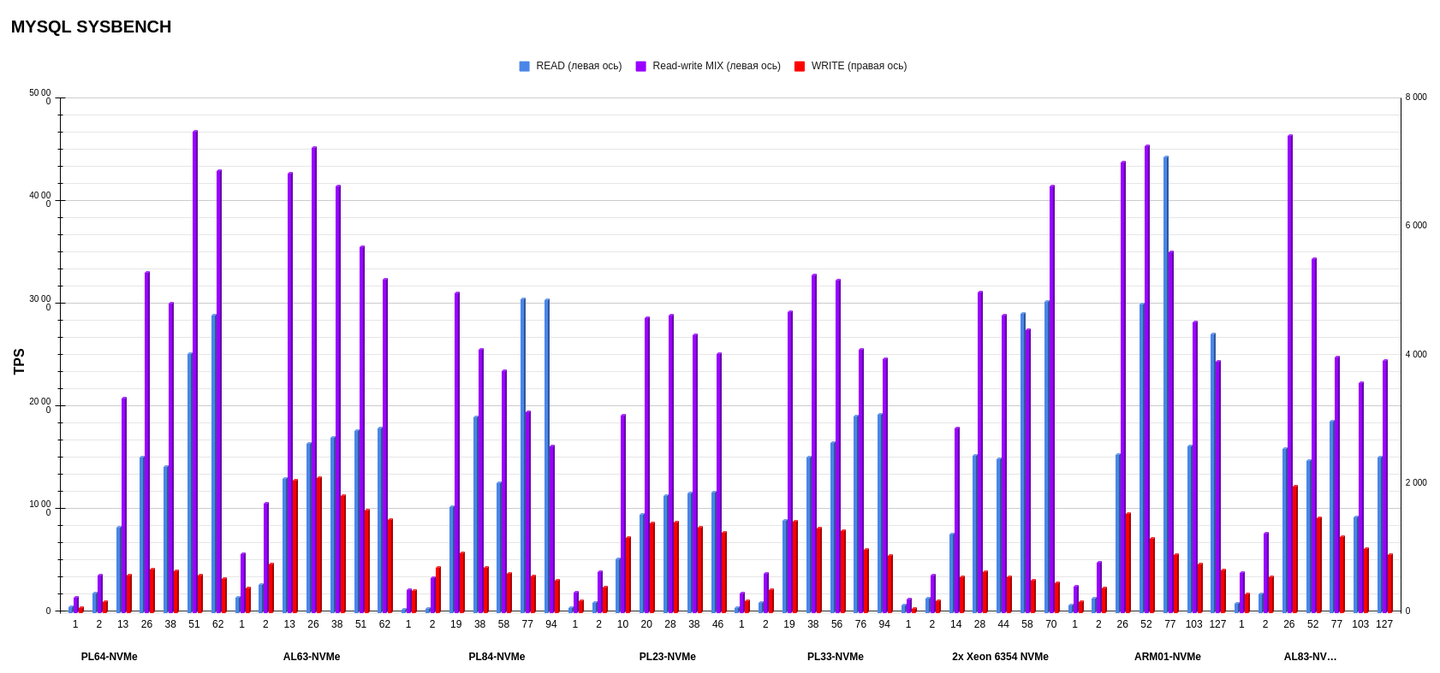
В данном тесте по средним показателям вперед вырывается ARM01 с Ampere Altra Max M128-30 и AL63 с 2 × AMD EPYC 7343 но если детально рассматривать операции, картина другая, более стабильную и лучшую работу по записи показывает AL63, когда ARM01 с увеличением потоков значительно проседает. Хорошие результаты на уровне показывают PL23 с 2 × Intel Xeon Silver 4214R и PL33 с 2 × Intel Xeon Gold 6240R процессоры второго поколения, они вырвались на уровень процессоров 3 го поколения по уровню миксованной чтению-записи и обгоняют по показателям записи PL84 с 2 × Intel Xeon Gold 6336Y и 2x Xeon 6354. Обобщенные результаты тестирования будут описаны в итогах тестирования.
Результаты MYSQLSLAP
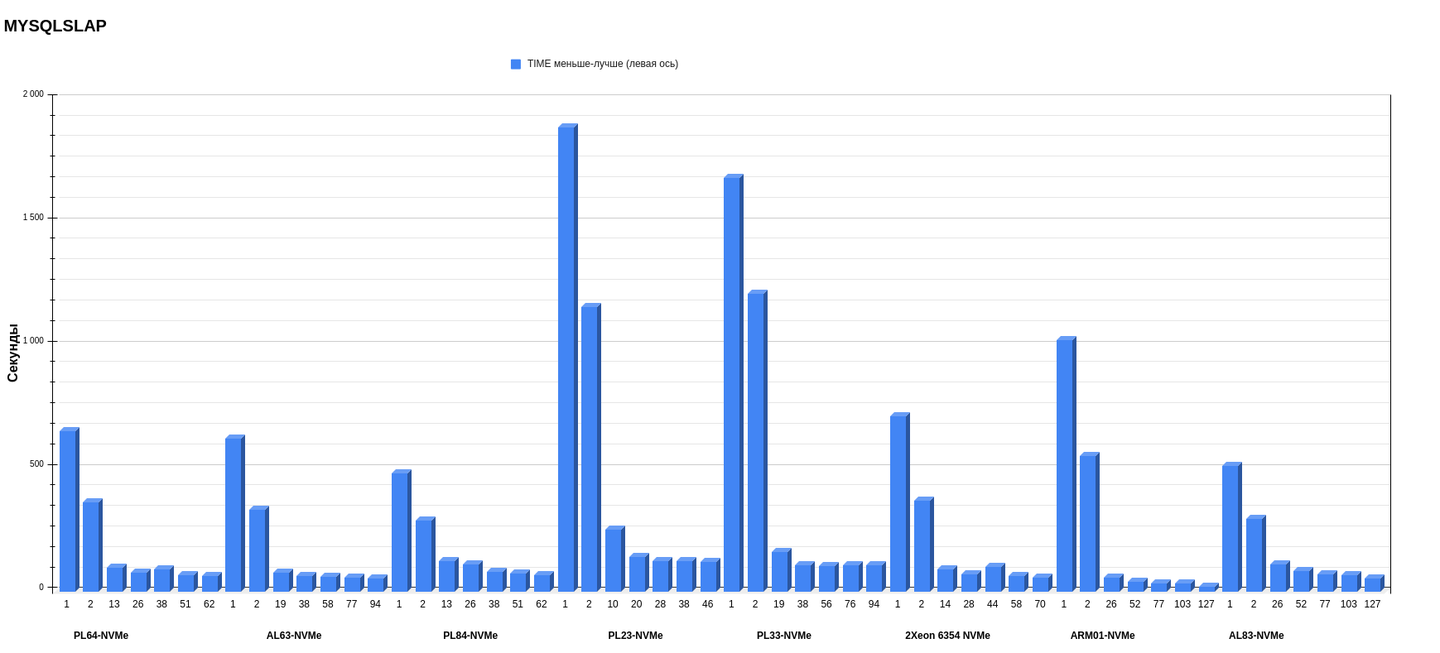
В тесте MYSQLSLAP метрика только в секундах из за этого график довольно простой и он один, хуже всего себя показали 2 поколение процов особенно в 1 и 2 потоках, лучше всего ARM при увеличении потоков и на 127 потоках. Тут стоит выделить две номинации так сказать, лучшей платформой справившейся с тестом в 1 и 2 потока оказалась PL84 c Intel Xeon Gold 6336Y. Вторая категория в многопотоке (больше 2х потоков) выигрывает с хорошим отрывом АРМ процессор который один справляется быстрее всех, Скорее всего ему на руку играет тот момент, что он разбивает общее кол-во запросов на большее количество пользователей. Поэтому один пользователь должен выполнить меньшее количество запросов. Как будет себя вести платформа на двух процессорах выясним в следующих тестах.
Итоги
Производительность баз данных варьируется в зависимости от конкретной архитектуры процессора и конфигурации сервера в целом. В результате, выбор подходящего процессора и сервера может существенно влиять на производительность баз данных и, в конечном итоге, на общую производительность приложений и сервисов.
В общем, процессоры AMD EPYC 7513, показали лучшую производительность в большинстве тестов, особенно в операциях записи и смешанных read/write сценариях. Это свидетельствует о сильной многопоточной производительности и оптимизации под рабочие нагрузки баз данных.
Процессоры Ampere Altra Max M128-30 на архитектуре ARM продемонстрировали хорошую производительность, особенно в тесте MySQLslap, благодаря большому количеству ядер и микроархитектурным оптимизациям, хотя в некоторых случаях они проигрывали x86 процессорам, особенно в операциях записи а так же в одном и двух потоках из за особенностей архитектуры..
В некоторых тестах, процессоры второго поколения Intel Xeon Silver 4214R и Intel Xeon Gold 6240R показали лучшую производительность по сравнению с процессорами третьего поколения. Это может быть связано с оптимизациями под конкретные рабочие нагрузки и микро архитектурными особенностями.
Некоторые артефакты производительности могут быть связаны что тестовая база данных не очень большая и распределение нагрузки между процессорами не равномерное.
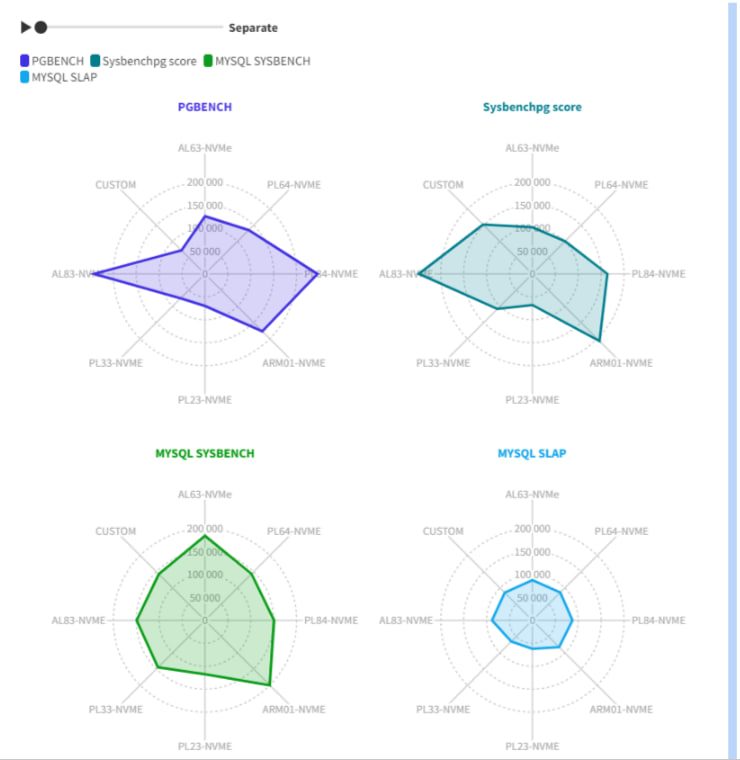
Выше мы рассмотрели все тесты по отдельности: чтение, запись, миксованная работа БД, но все таки хотелось оценить платформы в совокупности всех тестов так сказать дать общий балл по проведенным тестам, подсчитали количество транзакции по всем потокам не разделяя показатели по одному и двум потокам. А также оценить стоимость аренды данных платформ чтобы наши клиенты понимали что им выгоднее брать и для каких целей.
И так мы подсчитали общие “баллы”(TPS) по каждой платформе по каждому бенчмарку БД, теперь мы можем ориентироваться для каких целей выгоднее брать платформу можем посчитать экономику под конкретную задачу или проект. Данные “баллы” подсчитаны вне зависимости от количества потоков, то есть надо понимать что некоторые платформы показывают себя лучше в одном и двух потоках а некоторые в многопотоке. Цветом выделены топ результатов, первый второй и третий.
Фаворит явно AL83-NVME-10GE с 2 × AMD EPYC 7513 ей немного не хватило баллов чтобы получить первые результаты в 3х тестах, её немного обогнала платформа PL84-NVME в тесте pgbench. Но надо отметить что AL83-NVME-10GE это самое не бюджетное решение из за топового железа и дополнительной 10 гигабитной сетевой карты.
Далее идет платформа ARM01-NVME с одним процессором Ampere Altra Max M128-30 у неё один первый результат в MYSQL SYSBENCH, второй результат в SYSBENCH PG и третий результат в PGBENCH. Учитывая стоимость платформы данные результаты очень поражают что однопроцессорная система такой стоимости дает хорошую конкуренцию закоренелым лидерам процессорного рынка.
Третий результат у Intel платформы PL84-NVME у неё один первый результат в тесте pgbench, по всем остальным тестам стабильно занимала 3 результат по общим баллам бенчмарков.
Вот такие результаты и ответы на вопросы на что же обращать внимание при выборе платформы для проекта по базам данных (postgresql, MYSQL) мы получили. Процессор самый важный компонент в данном вопросе и их не обязательно должно быть много, платформа с ARM процессором это доказала и показала на примере своей производительности в данных бенчмарках. Также мы поняли что производительная платформа не всегда должна быть самой дорогой и это положительный момент для клиентов и пользователей.
В следующих тестах мы узнаем как покажут себя другие конфигурации а также самое интересное как покажет себя конфигурация АРМ с двумя процессорами Ampere Altra Max M128-30.
Ниже представил визуализацию какие результаты показывают платформы в обобщенных тестах, удобен ли такой формат просмотра и нужен ли вообще..? нужны комментарии