Мы в Selectel производим, собираем и ставим в прод серверы на Xeon 6 — с P-ядрами (Granite Rapids) и с E-ядрами (Sierra Forest). Разница между ними куда больше, чем «одно поколение CPU с двумя вариантами ядер», и на практике это два разных ответа на вопрос, под какую нагрузку вы вообще собираете сервер.
Небольшая предыстория
Сначала на рынок вышли серверные процессоры Xeon 6 на базе E-ядер (Efficiency Cores). Линейка Xeon 6 E-core — например, 6780E, 6760E, 6750E и другие — позиционируется как решение для высокоплотных, массово-параллельных нагрузок: микросервисов и приложений в контейнерах, облачных и edge-платформ, веб-сервисов, CDN, кэширования, сетевых и коммуникационных задач.
Бизнес-требования, под которые создавалась эта серия, включают снижение совокупной стоимости владения (TCO) за счёт экономии энергии и оптимизации охлаждения; высокую плотность развёртывания — до нескольких сотен ядер на сервер, что особенно важно для дата-центров с ограничением по площади и энергопотреблению; масштабируемость под облачные и распределённые среды; и универсальность для типовых сервисов, не требующих расширенных векторных вычислений — то есть без AVX-512 и AMX.
Получается, что Xeon 6 на E-ядрах — это CPU для эффективной и масштабируемой инфраструктуры, а не для максимальной производительности на поток. Именно с такими процессорами Selectel впервые анонсировал свою серверную платформу, и результаты тестов уже разбирали в отдельной статье.
Дальше мы ждали P-ядра (Performance Cores), известные под кодовым названием Granite Rapids. В отличие от E-ядер, у P-ядер есть поддержка Hyper-Threading, поддержка AVX-512 и AMX (Advanced Matrix Extensions) — что критично для задач ИИ и машинного обучения, — а также более высокая частота и увеличенные кэши.
Линейка Xeon 6 P-core — например, 6980P, 6970P, 6960P и другие — предназначена для HPC, облачных вычислений, аналитики больших данных и обучения нейросетей, виртуализации корпоративного уровня и бизнес-критичных приложений, которым нужна высокая одно- и многопоточная производительность. С точки зрения бизнеса, Xeon 6 P-core создавались для компаний, у которых ключевые требования — максимальная производительность на поток, гибкость масштабирования вычислительных ресурсов и поддержка современных инструкций для ИИ и ML. CPU на P-ядрах позиционируют себя как решение для требовательных корпоративных и научных нагрузок.
Все были уверены, что P-линейка гораздо мощнее и будет обгонять E-ядра по всем показателям. На деле не всё так однозначно: P-ядра мощнее на поток и хорошо считают тяжёлые вычисления, но в ряде тестов баз данных E-ядра обгоняют P-ядра на 15–20% — и дальше мы разберём, почему. Думаю, это неплохая инструкция для клиентов при выборе сервера, особенно когда команда до конца не понимает разницу между линейками и на что вообще смотреть.
Зачем Intel вообще «разделил» Xeon 6
Исторически процессоры Xeon были универсальными: один тип CPU подходил и для баз данных, и для веб-сервисов, и для HPC. Но с ростом облачных нагрузок и специализированных задач — контейнеризация, AI/ML, edge-computing — стало ясно, что один универсальный CPU не может одинаково хорошо закрывать всё сразу. Для одних сценариев критична производительность на ватт, для других — стоимость вычислительного ресурса (TCO). Облачные провайдеры и дата-центры вроде AWS, Google Cloud, Azure и Alibaba Cloud стали ориентироваться не на «самый мощный CPU», а на CPU, оптимальный под конкретный тип нагрузки.
Похоже, Intel увидела этот тренд и разделила Xeon 6 на две ветви: Sierra Forest (E-core) — для массовых, параллельных и энергоэффективных задач, и Granite Rapids (P-core) — для нагрузок с высокой вычислительной плотностью на поток и поддержкой AI/ML-инструкций. Такое разделение позволило оптимизировать платформу под конкретные сценарии, а не под «средний по больнице» профиль нагрузки.
Куда смотрят облака
Современные hyperscale-компании измеряют эффективность в ваттах на запрос, а не просто в гигагерцах. Их всё чаще интересуют энергоэффективность (Perf/Watt), стоимость владения (TCO), плотность размещения ядер на стойку и гибкость масштабирования под тип нагрузки. Многие облака — Google, AWS, Azure — уже используют гибридные кластеры, где ресурсы подбираются не по количеству ядер вообще, а по профилю конкретного сервиса.
Почему универсальные CPU перестали быть оптимальными
Раньше универсальный серверный CPU был удобен: одна архитектура, одна платформа, меньше сложностей для интеграции. Но у этого удобства есть цена. Для лёгких сервисов такой CPU слишком мощный — и прожорливый. Для тяжёлых вычислений — наоборот, ограниченный по инструкциям или частоте. Для hyperscale-инфраструктуры это выливается в миллионы долларов переплаты за электроэнергию и охлаждение. Именно поэтому рынок движется к специализации CPU, когда разные ядра и даже разные архитектуры — x86, ARM, RISC-V — закрывают разные классы задач вместо одного «среднего» решения.
Типовые ошибки при выборе сервера или CPU
Даже в крупных ИТ-инфраструктурах до сих пор встречаются одни и те же неверные подходы к выбору серверов и процессоров. Разберу два самых частых.
Ошибка №1. «Берём побольше ядер — и будет быстрее». Это одно из самых устойчивых заблуждений. Количество ядер действительно важно, но масштабируемость по ядрам не линейна. Во многих рабочих сценариях — веб-приложения, API, базы данных, ETL-пайплайны, аналитика в памяти — производительность быстрее упирается не в число ядер, а в пропускную способность памяти (memory bandwidth), задержки при межъядерном взаимодействии, ограничения со стороны хранилища или сети и программные блокировки внутри самого приложения.
Ошибка №2. «Главное — мощность, остальное неважно». Нередко выбор делается по чистым спецификациям: частота, кэш, TDP. Но без учёта энергоэффективности, характера нагрузки и реального SLA такой выбор часто оказывается избыточным и просто дороже в эксплуатации.
Резюме про современные CPU
Современный CPU — это не просто «коробка с ядрами», а элемент оптимизированной экосистемы. Ошибка в выборе CPU или сервера способна незаметно съедать бюджет годами: через переплату за электроэнергию, охлаждение и простаивающие ресурсы, которые на бумаге выглядят внушительно, а по факту не используются нагрузкой.
Бенчмарки
Посмотрев на эти процессоры, мы увидели колоссальную разницу в профиле их применения — и не ожидали таких результатов. Бенчмарки приложений тестировались на двухсокетных серверах Selectel: сиреневый — Xeon 6710E, 128 ядер (128 потоков); зелёный — Xeon 6530P, 64 ядра (128 потоков).
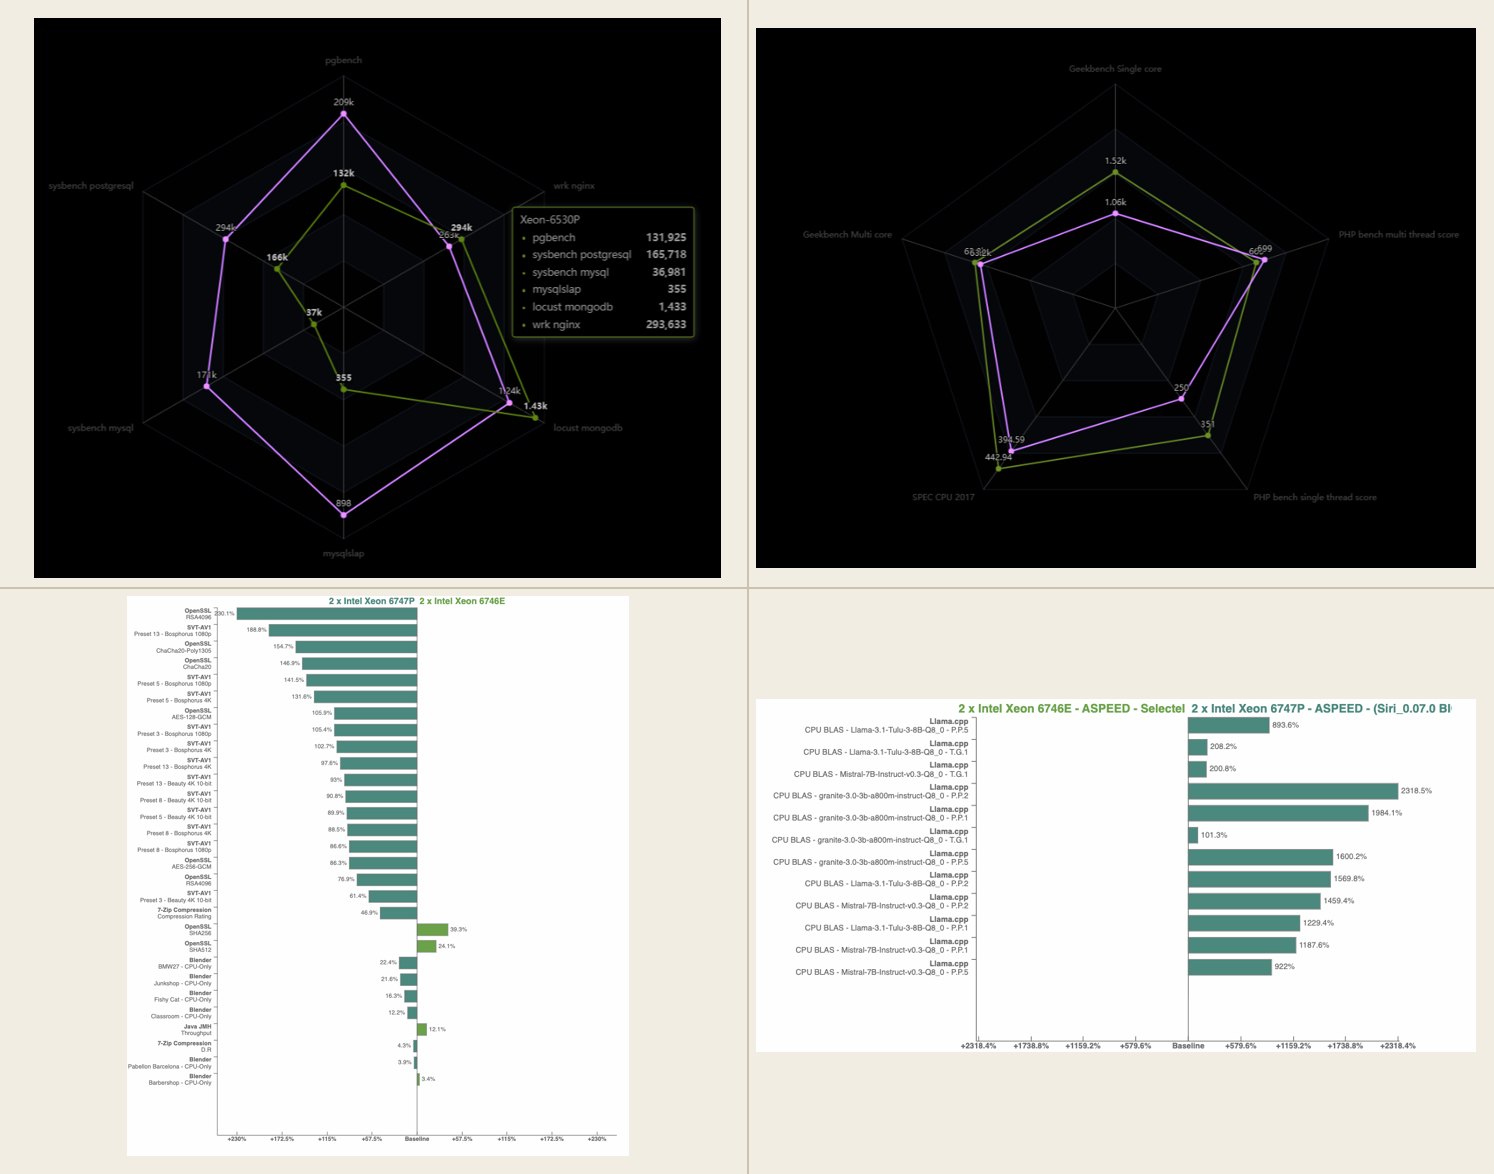
По прикладным бенчмаркам видно, что P-ядра сильно уступают по большинству сценариев — для нас это сначала было неочевидно. А вот на синтетике всё было предсказуемо: больше частота, дороже процессор — выше цифры. По синтетическим бенчмаркам преимущество у P-ядер есть, но не такое уж большое. Поэтому мы пошли дальше и стали смотреть на нагрузки, где P-ядра действительно должны быть сильнее.
И мы нашли, в чём P-ядра уверенно превосходят E-ядра — конечно же, это ML и HPC-задачи. Здесь разрыв уже кратный: широкие векторные блоки AVX-512 и AMX дают P-ядрам решающее преимущество там, где E-ядра просто не могут конкурировать по архитектуре.